AI 에이전트 데이터 통합을 위한 서버리스 MCP 서버 구축
들어가기
AWS는 AI 에이전트를 통한 데이터 접근 문제를 해결하기 위해 다양한 솔루션을 제공합니다. 대다수의 조직은 AI 기반 응용 프로그램을 개발할 때 비슷한 어려움에 직면하게 됩니다. 특히, 큰 언어 모델(Large Language Model, LLM) 에이전트를 기업의 데이터 호수(Data Lake)에 연결하는 것은 복잡하고, 각각의 에이전트와 응용 프로그램에서 동일한 통합 로직이 중복되기 쉽습니다. 본 블로그에서는 AWS Fargate를 통한 서버리스 모델 컨텍스트 프로토콜(Model Context Protocol, MCP) 서버 구축 사례를 소개합니다.
본문
문제점과 설계 목표
기업 내 다양한 팀들이 데이터와 상호작용하기 위해 AI 도우미를 요청하게 되는데, 이들은 각자 특화된 통합을 개별적으로 구축해야 했습니다. 이는 데이터 스키마 변경 시 모든 에이전트를 패치해야 하는 비효율을 초래하게 됩니다. 따라서, 단일한 접근 제어 및 데이터 접근 결정을 위한 감사 포인트가 필요하며, 데이터셋 온보딩에도 며칠이 소요되었습니다.
솔루션 개요
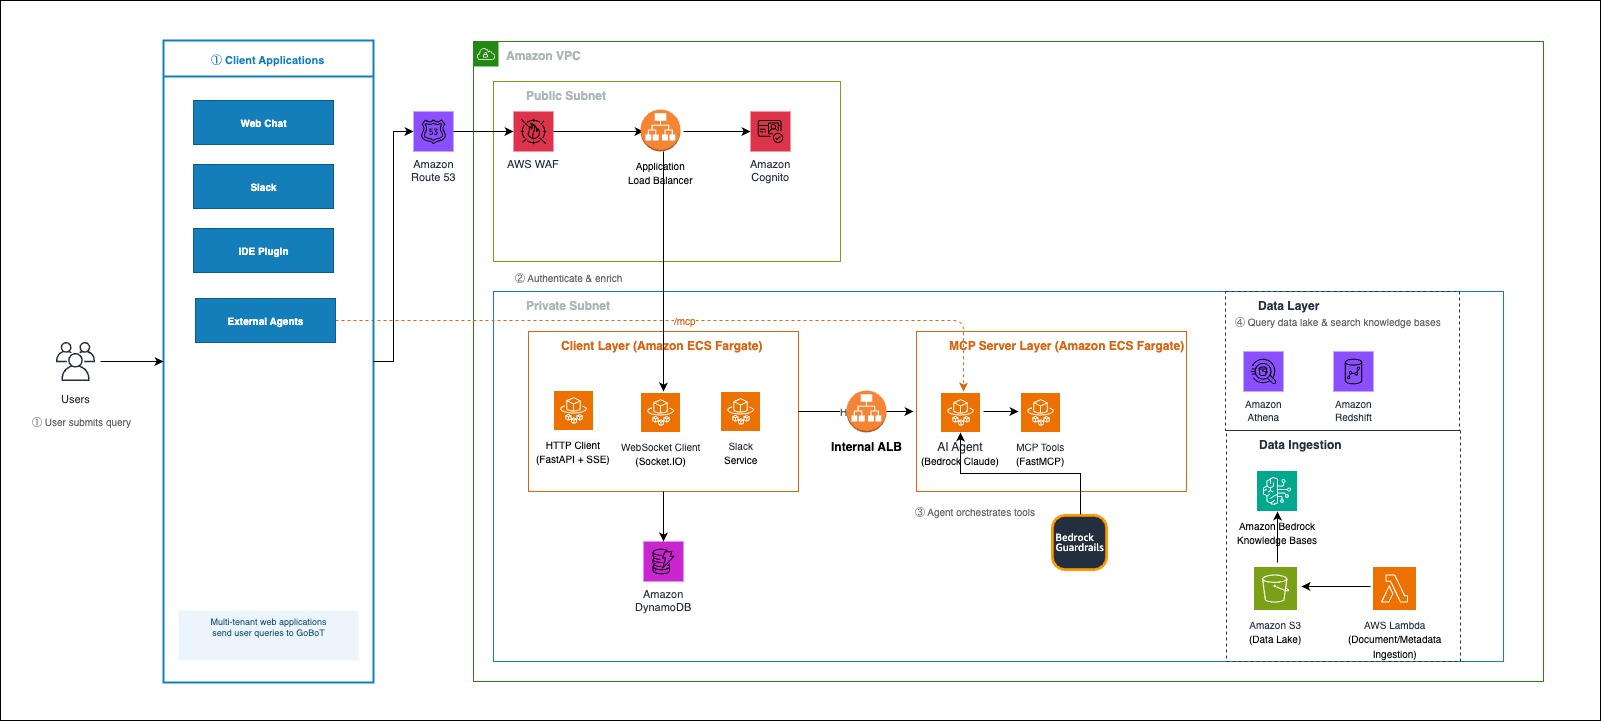
제안된 아키텍처는 크게 클라이언트, MCP 서버, 툴, 그리고 지식 베이스 갱신의 네 가지 레이어로 나뉩니다. 특히, MCP 서버는 중앙 집중식 에이전트 무관성을 제공하며, JSON 메타데이터 파일을 통해 데이터셋을 쉽게 등록할 수 있습니다.
아래 아키텍처의 요청 흐름은 사용자 쿼리에서 데이터 레이어에 이르기까지 각 레이어를 통해 전달되는 과정을 보여줍니다.
클라이언트 레이어: 인증 및 세션 관리
요청은 Amazon Route 53을 통해 DNS가 해결되고, HTTPS 및 AWS WAF 구성의 Application Load Balancer를 통해 라우팅됩니다. 여기서 Amazon ECS Fargate 클라이언트 서비스가 JSON 웹 토큰(JWT) 인증을 제공하고, Amazon DynamoDB에 세션을 저장합니다.
MCP 서버 레이어: 상태 없는 실행
MCP 서버는 자체 ECS Fargate 클러스터에서 실행되며, 모든 요청은 Amazon Route 53과 내부 Application Load Balancer를 통해 라우팅됩니다. 이 서버는 쿼리 분석, 도구 선택, 실행 및 응답 생성을 포함한 전체 오케스트레이션을 처리합니다.
툴 레이어 및 메타데이터 기반의 데이터 호수 접근
FastMCP에 등록된 각 도구는 실행 시 발견 가능하며, Amazon Athena 및 Amazon Redshift에 대해 SQL 쿼리를 수행합니다. 또한 내부 문서 및 테이블 메타데이터 검색도 가능하여 AI 에이전트가 자연어로 응답을 형성할 수 있게 해줍니다.
책임 있는 AI 제어
모든 LLM 상호작용은 Amazon Bedrock Guardrails를 통해 필터링되며, 이 선별 기준은 생산 상에서 데이터 보안 정책 내용을 엄격히 준수합니다. Athena 쿼리 도구는 SELECT 쿼리만 수행하도록 제한되어 데이터 호수를 보호합니다.
결론
이 아키텍처는 AI 에이전트와 기업 데이터 호수 간의 중앙 집중식 게이트웨이를 제공합니다. 메타데이터 기반의 접근 방식은 데이터셋 통합 코드를 필요로 하지 않으며, MCP 표준에 따라 다양한 클라이언트를 지원합니다.
이와 관련하여 AWS의 다양한 서비스, 특히 Amazon ECS, AWS Fargate, Amazon Bedrock 및 아테나와 관련된 확장 가능한 인프라 활용 방법에 대해 자세히 알아보시길 바랍니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기