AWS에서 코코로-82M 모델을 아마존 세이지메이커(Amazon SageMaker) AI 실시간 엔드포인트에서 커스텀 컨테이너로 배포하고 오토스케일링을 최적화하는 방법을 다루는 포스트입니다.
도입
AWS의 텍스트-투-스피치(TTS) 엔드포인트가 예상치 못한 트래픽 급증을 겪을 때, 오토스케일링 정책은 이러한 상황을 해결하기 위해 설계되었지만, 종종 불확실한 추정값이 되곤 합니다. 이 블로그 포스트에서는 오토스케일링의 추측을 실제 측정치로 대체하여 코코로-82M 모델을 성공적으로 배포하는 방법에 대해 설명합니다.
본론
- 자동화된 TTS 오토스케일링의 문제점: 전통적인 오토스케일링 메트릭은 비동기 요청/응답 패턴에 적합하지만, TTS의 경우에는 여러 요청이 장시간 열려 있어야 하기 때문에 적합하지 않습니다.
- 코코로-82M 배포 경로: AWS Cloud Development Kit (AWS CDK)와 함께 커스텀 GPU 컨테이너를 아마존 세이지메이커 AI 실시간 엔드포인트에 배포합니다.
- 실측 값 활용: Q_max는 하나의 인스턴스가 처리할 수 있는 동시 요청의 최대치이며, T_total은 실제 확장 시간입니다.
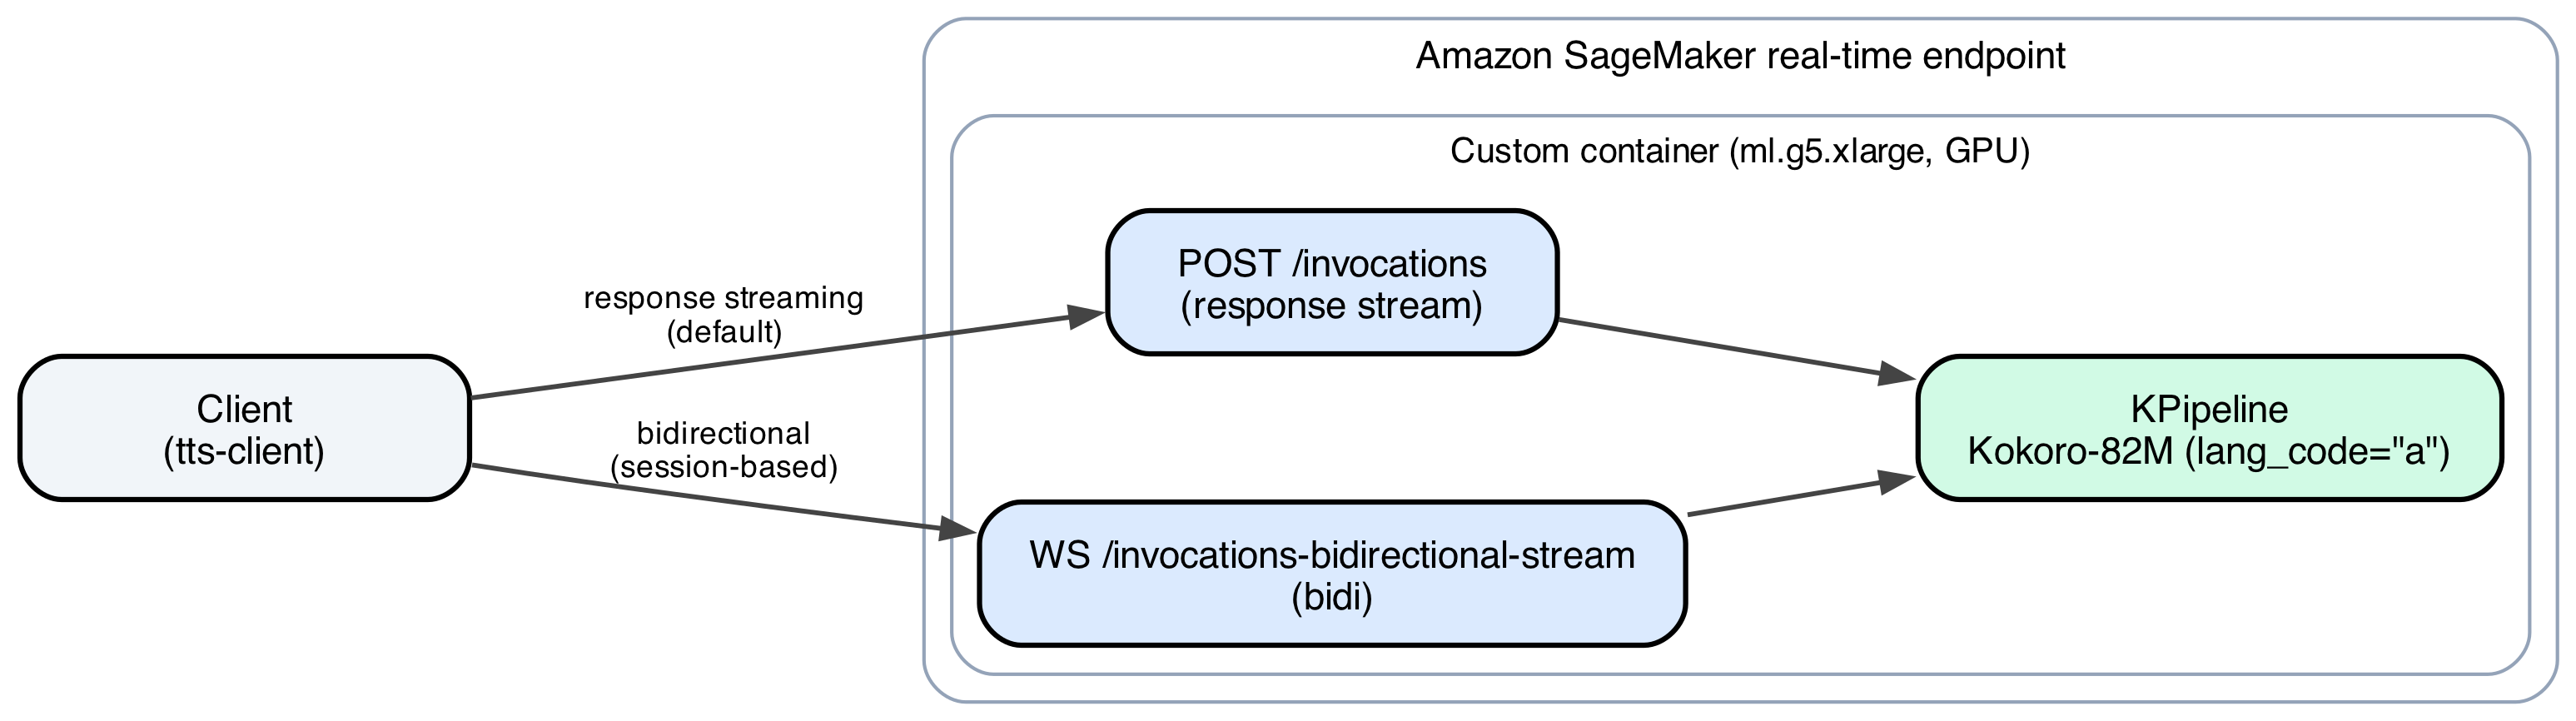
사례 연구: Kokoro-82M 모델의 오토스케일링 최적화
- Q_max 측정: 한 인스턴스가 처리할 수 있는 최대 동시 요청 수
- T_total 측정: 용량 추가 요청부터 새로운 인스턴스가 트래픽을 처리하기 시작할 때까지의 실제 시간
결론
측정 기반의 오토스케일링 정책을 통해 각 숫자가 자사 엔드포인트에 대한 실제 측정에 의해 뒷받침됩니다. 이는 실제 수치를 기반으로 정책을 확립하여, 효율적인 리소스 활용과 안정적인 성능을 보장합니다. 이는 텍스트-투-스피치뿐 아니라 다른 실시간 AI 엔드포인트에도 적용할 수 있습니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기