Amazon SageMaker HyperPod 추론 게이트웨이 도입
AWS는 Amazon SageMaker HyperPod 추론 게이트웨이를 통해 고성능 추론 환경을 제공하고 있습니다. 이 시스템은 Kubernetes 네이티브 환경에서 GPU 자원을 최적화하여 첫 번째 토큰 지연 시간을 최대 82%까지 줄일 수 있는 솔루션을 제공합니다.
문제점: 비효율적인 라우팅으로 인한 자원 낭비
대규모 언어 모델(LLM)을 GPU 클러스터에서 운영하면 높은 비용이 발생할 수 있습니다. 기본 Kubernetes 로드 밸런서는 이러한 문제를 악화시켜, 일부 파드가 과부하 상태일 때에도 유휴 자원이 활용되지 않게 됩니다. 이로 인해 예측할 수 없는 GPU 사용률과 높은 지연 시간이 발생하며, 비용 낭비로 이어집니다.
솔루션: SageMaker HyperPod 추론 게이트웨이
새롭게 공개된 Amazon SageMaker HyperPod 추론 게이트웨이는 Kubernetes 네이티브의 GPU 인식 라우팅 시스템으로, 모델 서버나 클라이언트 응용 프로그램의 변경 없이 실시간 GPU 신호를 활용해 최적의 파드에 요청을 배치합니다. 따라서 지연 시간이 현저히 감소하게 됩니다.
작동 방식: 이중 구조 아키텍처
추론 게이트웨이는 Envoy Gateway, Body-Based Router, Endpoint Picker로 구성된 이중 구조를 통해 추론 요청을 최적화합니다.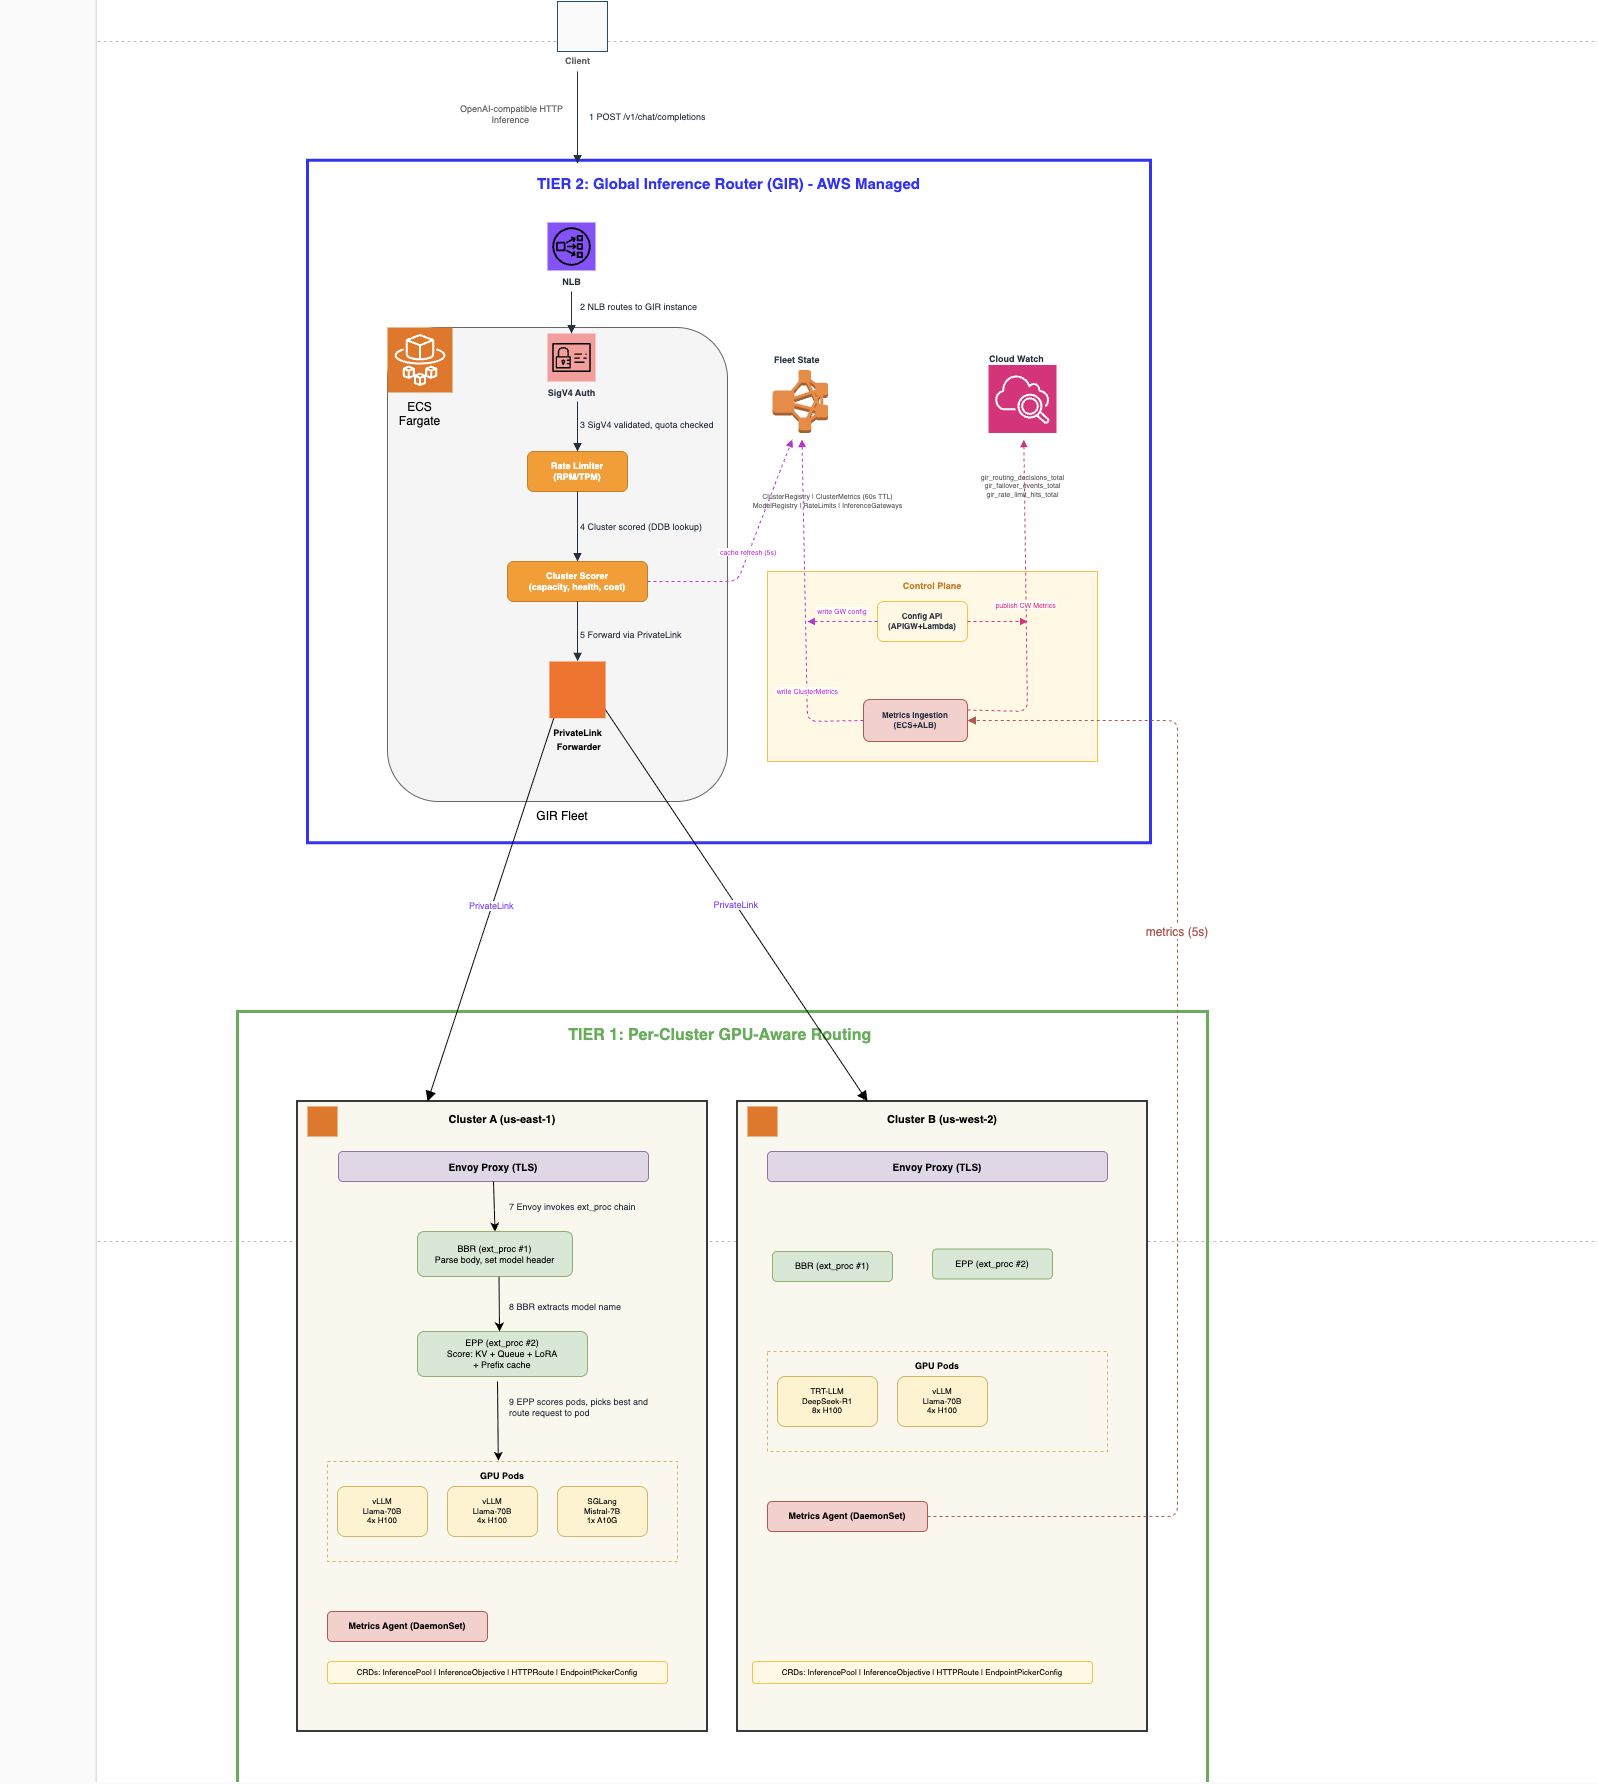
- Envoy Gateway: 고성능 L7 프록시로, HTTPS 트래픽을 종료하고 각 클러스터에 대한 단일 엔드포인트를 노출합니다.
- Body-Based Router (BBR): OpenAI-호환 요청 본문을 검사하고 올바른 모델 풀에 라우팅합니다.
- Endpoint Picker (EPP): 실시간 메트릭을 활용하여 최적의 백엔드를 선택합니다.
빠르게 시작하기
- 애드온 설치:
aws eks create-addon --cluster-name my-hyperpod-cluster --addon-name amazon-sagemaker-hyperpod-inference - 모델 파드 레이블: 해당 모델 서버에 레이블을 추가하여 게이트웨이가 이를 탐지할 수 있도록 합니다.
- 게이트웨이 설정 적용:
InferenceGatewayConfig리소스를 생성하여 모델과 라우팅 동작을 정의합니다.
실제 사례 및 성능 개선 분석
권장 시나리오에서는 Round-Robin과 비교하여 지연 시간이 크게 감소하고, GPU 사용 효율성이 향상되었습니다. 따라서, 전통적인 라우팅 방식에서 벗어나 혼합 GPU 세대, 버스트 트래픽, 공유 프롬프트 프리픽스 등 다양한 실세계 시나리오에서 높은 성능 향상을 기대할 수 있습니다.
이미 SageMaker HyperPod 추론 게이트웨이를 통해 사용 가능한 환경이 제공되며, 글로벌 추론 라우터와 같은 차세대 기능이 추가될 예정입니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기