자기 호스팅 LLM의 비용과 지연 시간 절감을 위한 분산 KV 캐싱 기술
AI와 클라우드 관련 기술이 꾸준히 발전하면서, 대규모 언어 모델(LLM)을 GPU에서 자체 호스팅하여 비용, 정확도, 지연 시간을 자체적으로 관리하려는 기업들이 늘어나고 있습니다. 그러나, 개별 서버에 있는 작은 캐시는 AI 에이전트 및 채팅 애플리케이션이 보내는 점점 커지는 컨텍스트를 보관하거나 공유할 수 없어, 불필요한 GPU 작업에 비용이 듭니다. 이 문제는 법률 AI 비서처럼 대화 내역이 수십만 개의 토큰으로 증식하는 애플리케이션에서 특히 두드러집니다.
분산 KV 캐싱의 주요 역할
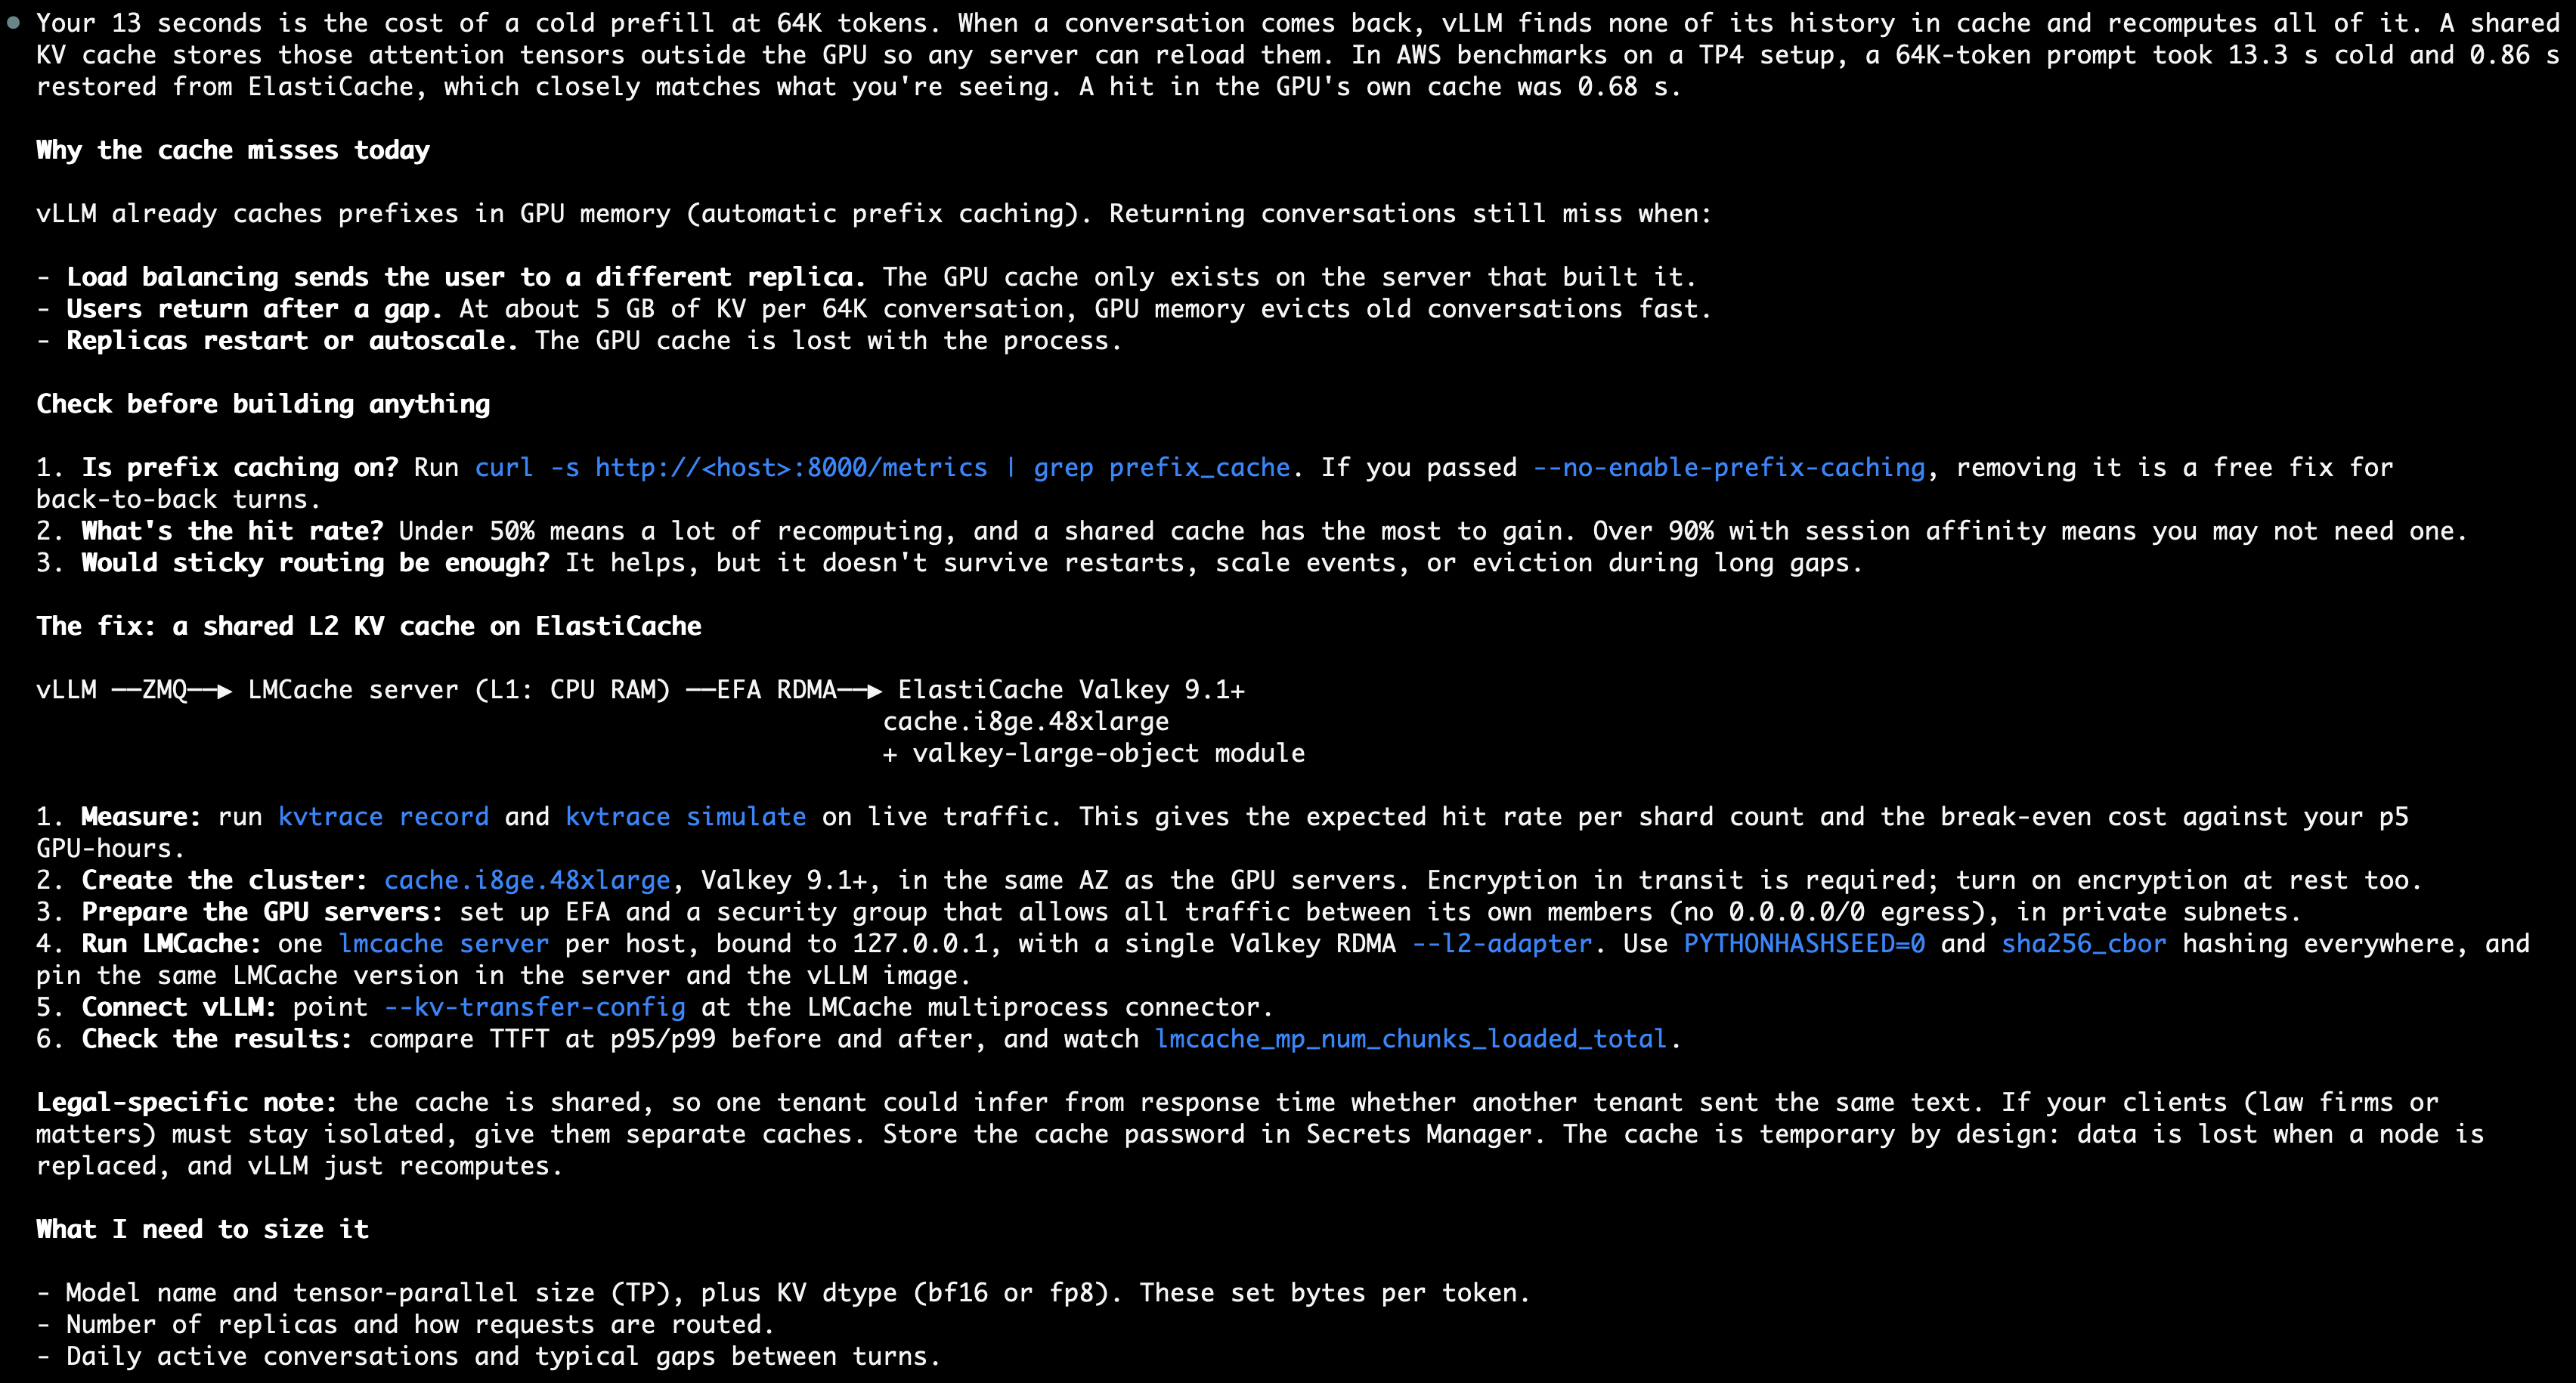
Amazon ElastiCache를 활용한 분산 KV 캐싱은 자체 호스팅 LLM 추론 비용을 최대 40%까지 줄이고, 첫 토큰까지의 시간(TTFT)을 최대 80%까지 절감할 수 있습니다. 분산 KV 캐싱은 GPU 로컬 캐시의 확장을 통해 KV 상태를 세션, 라우팅 변경 및 서버 장애 시에도 며칠 동안 반복 사용 가능하게 합니다.
분산 KV 캐싱 스킬 개요
AWS의 Agent Toolkit에서 제공되는 분산 KV 캐싱 스킬은 작업 부하의 이점을 평가하고, 캐시 클러스터를 설정하며, LLM 추론 캐싱 문제를 해결하는 방법에 대해 안내합니다. 다양한 코딩 에이전트(Kiro, Claude Code, OpenAI Codex 등)와 함께 작동하며, 네 가지 주요 흐름을 통해 사용법을 소개합니다.
분산 KV 캐싱의 단계별 사용법
-
도움이 되는지 평가: LLM이 사용하는 모델, 사용자 트래픽 패턴 및 프롬프트 라우팅 선택과 같은 특성에 따라 캐싱의 이점이 결정됩니다. KVTrace 도구를 사용하여 실제 모델 및 트래픽으로부터 계산된 이점을 평가할 수 있습니다.
-
절감액 추정: 에이전트는 GPU 및 캐시 노드 가격을 조회하고, 벤치마크로부터 사전 채우기 속도 및 KV 크기를 계산합니다. 계산된 수치를 기반으로 추천된 캐시 노드를 설정할 수 있습니다.
-
분산 KV 캐싱 설정: 에이전트는 사용자의 확인을 받아, 적절한 보안 그룹 설정과 함께 Valkey 9.1 클러스터를 생성하여 KMCache 서버를 시작합니다.
-
문제 해결: RDMA 전송 오류 등 발생할 수 있는 문제에 대해 에이전트는 진단 및 해결 안내를 제공합니다.
결론
효과적인 분산 KV 캐싱의 구현은 사용자 맞춤형 에이전트의 응답 시간을 줄이고 불필요한 GPU 작업을 줄이는 데에 큰 기여를 할 수 있습니다. 이러한 최적화는 비용 절감뿐만 아니라 서비스 품질 향상에도 직접적으로 기여하게 됩니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기