SageMaker AI의 KV-인지 라우팅: 효율적인 LLM 서버 운영을 위한 가이드
소개
최근 많은 기업들이 AI 기술을 도입하여 업무를 자동화하고, 보다 나은 고객 경험을 제공하는데 주력을 하고 있습니다. 특히 대형언어모델(LLM)의 활용이 늘어나면서, 이를 효율적으로 운영할 수 있는 방안이 필요해지고 있습니다. 이번 포스팅에서는 AWS SageMaker AI가 새롭게 도입한 KV-인지 라우팅(KV-aware routing) 전략을 중심으로 LLM 서버의 효율성을 높이는 방법에 대해 알아보겠습니다. KV-인지 라우팅은 실시간 엔드포인트에서 캐시 상태를 활용하여 요청을 가장 적합한 인스턴스로 라우팅함으로써, 성능을 최적화할 수 있는 새로운 전략입니다.
본문
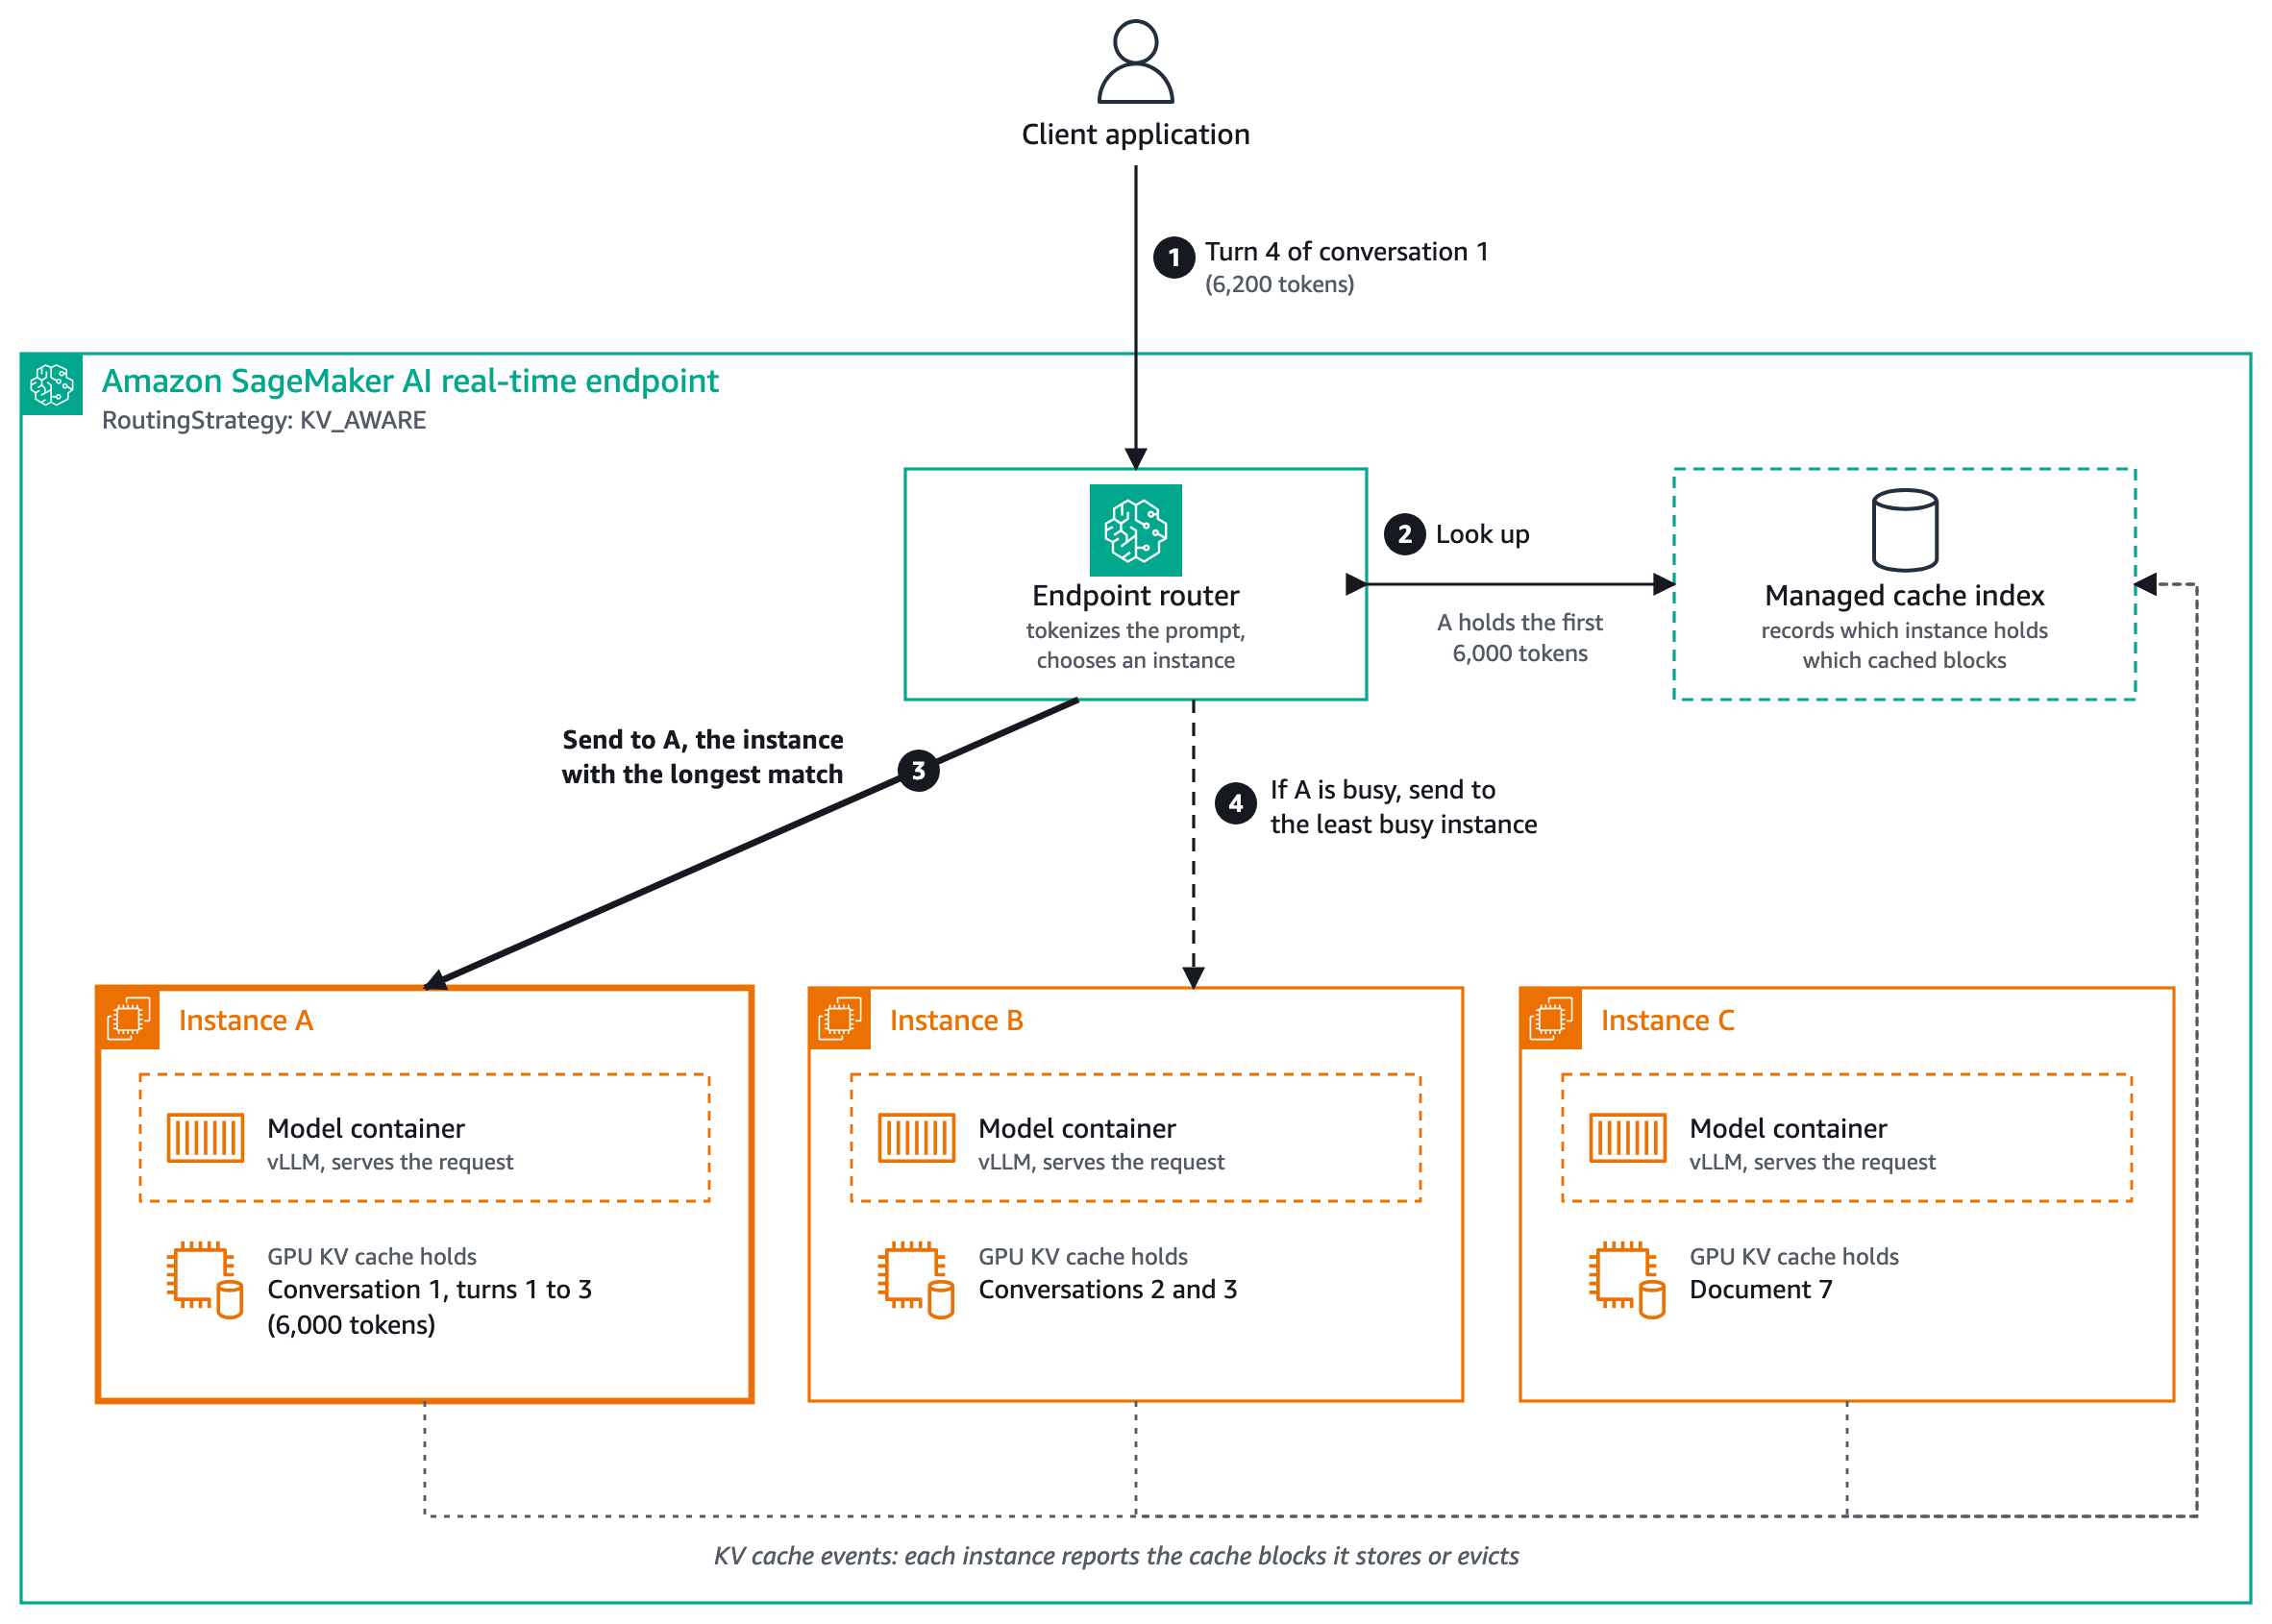
KV-인지 라우팅의 작동 원리
KV-인지 라우팅은 모델 컨테이너가 캐시 상태를 보고하고, SageMaker AI가 해당 정보를 기반으로 각 요청을 최적의 인스턴스로 라우팅하는 방식으로 작동합니다. 중요 포인트는, 이 전략이 Fluent API와 같은 이전의 API와 호환된다는 점입니다.
환경 변수 설정 예제: "SM_VLLM_KV_EVENTS_CONFIG"
활용 사례 및 성능
KV-인지 라우팅은 주로 LLM 서버에서 다중 턴 대화나 큰 시스템 프롬프트를 사용하는 애플리케이션에 적합합니다. 기존의 Prefix-인지 라우팅과 비교했을 때, 더 긴 프롬프트나 빈번한 캐시 갱신이 발생하는 경우 유리합니다.
벤치마크 결과: KV-인지 라우팅을 적용한 결과, 첫 번째 토큰까지의 시간(Time to First Token)이 최대 97% 감소했으며, 처리량은 234%까지 증가했습니다. 긴 프롬프트를 사용할 때 더욱 두드러지는 성능 향상을 보여줍니다.
결론
KV-인지 라우팅은 SageMaker AI에서 실시간 엔드포인트를 더 효과적으로 활용할 수 있게 해주는 혁신적인 기능입니다. 이 전략을 통해, LLM 서버의 응답 성능을 최대화할 수 있으며, 사용자 경험을 개선할 수 있습니다. 향후 AI 기반 시스템을 구축하고자 하는 팀들이라면 이 기능을 활용하여 최적화된 성능을 경험해보시길 추천드립니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기