소개
오늘 우리는 Amazon EKS와 SageMaker HyperPod EKS에서 NVIDIA Nemotron 모델을 활용하여 에이전틱 AI를 가속화하는 방법에 대해 탐구하고자 합니다. 이 블로그 글에서는 NVIDIA Nemotron 3.5 Super VL의 아키텍처와 활용 사례를 살펴보고, AWS 상에서 이를 배포하는 방법과 성능 평가에 대해 논의합니다.
본문
NVIDIA Nemotron 3.5 Super VL은 120B 파라미터를 가진 혼합 전문가(MoE) 모델로, 텍스트 및 비주얼 작업 모두에 대응하는 개방 멀티모달 모델입니다. 모델 아키텍처는 Mamba-Transformer MoE 구조를 기반으로 하며, NVIDIA의 참조 구현을 통해 주요 오픈 에이전트 프레임워크와 통합됩니다. 이를 통해 AI 에이전트 워크플로우가 더욱 진보된 형태로 실행될 수 있습니다.
Nemotron 3.5 Super VL의 활용 사례는 다음과 같습니다:
- 코딩: 코드 테스트 및 검증, 오류 분석 및 수정 추천
- 웹 리서치: 검색 도구가 반환한 소스 교차 검증
- 문서 인텔리전스: 표, 차트, 페이지 레이아웃을 읽고 요약 생성
- 사이버 보안: 취약점 발견 및 위협 해결
- 비디오 이해: 검색, 콘텐츠 리뷰, 사건 분석
Nemotron 3.5 Super VL은 Amazon EKS, EKS Auto Mode, SageMaker HyperPod EKS에서 배포할 수 있으며, AWS 관리 하에 클러스터 스케일링과 GPU 지원을 받을 수 있습니다.
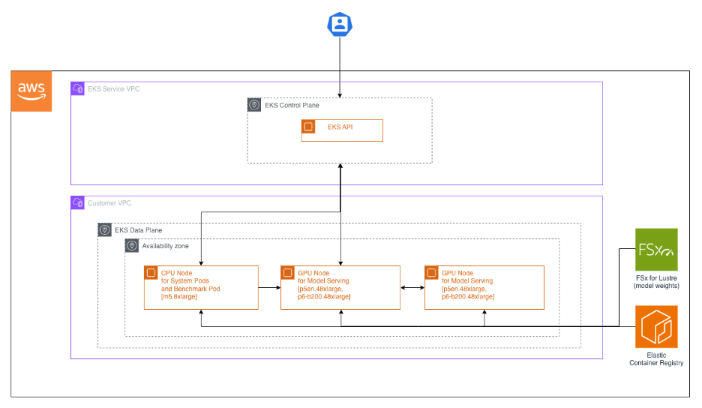
배포 아키텍처에는 표준 Amazon EKS 클러스터 구조를 따르며, CPU 및 GPU 데이터 플레인 노드가 포함됩니다. Amazon Elastic Container Registry와 Amazon FSx for Lustre는 컨테이너 이미지와 모델 가중치를 저장합니다.
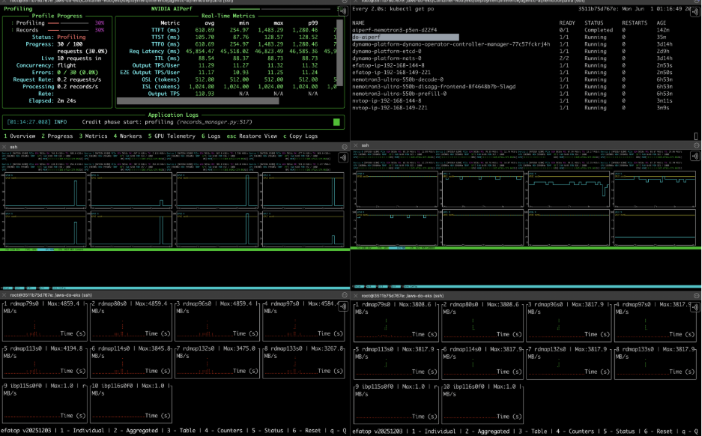
성능 검증과 관련된 부분에서는 NVIDIA의 Aiperf 도구를 통해 클러스터 내 배포된 모델의 성능을 측정할 수 있습니다. 또한, 다양한 동시성 수준에서 성능 데이터를 수집하여, 대기 시간 및 처리 능력을 분석할 수 있습니다.
결론
이번 글에서는 NVIDIA Nemotron 모델을 Amazon EKS, EKS Auto Mode, SageMaker HyperPod EKS에 배포하는 과정과 관련 성능 평가 패턴을 다루었습니다. Nemotron 3.5 Super VL을 AWS 계정에 직접 배포하며, AI on EKS 프로젝트에서 제공하는 다양한 인퍼런스 블루프린트도 활용할 수 있습니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기