Amazon SageMaker AI에서 Kokoro TTS를 활용한 저지연 AI 에이전트 구축 가이드
AI 음성 에이전트와의 상호작용은 사용자 경험에 중대한 영향을 미칩니다. 고객의 질문에 에이전트가 답변하기까지의 대기 시간이 길어지면, 사용자는 답답함을 느낄 수 있습니다. 이 글에서는 이러한 지연을 어떻게 줄일 수 있는지 살펴봅니다.
본문
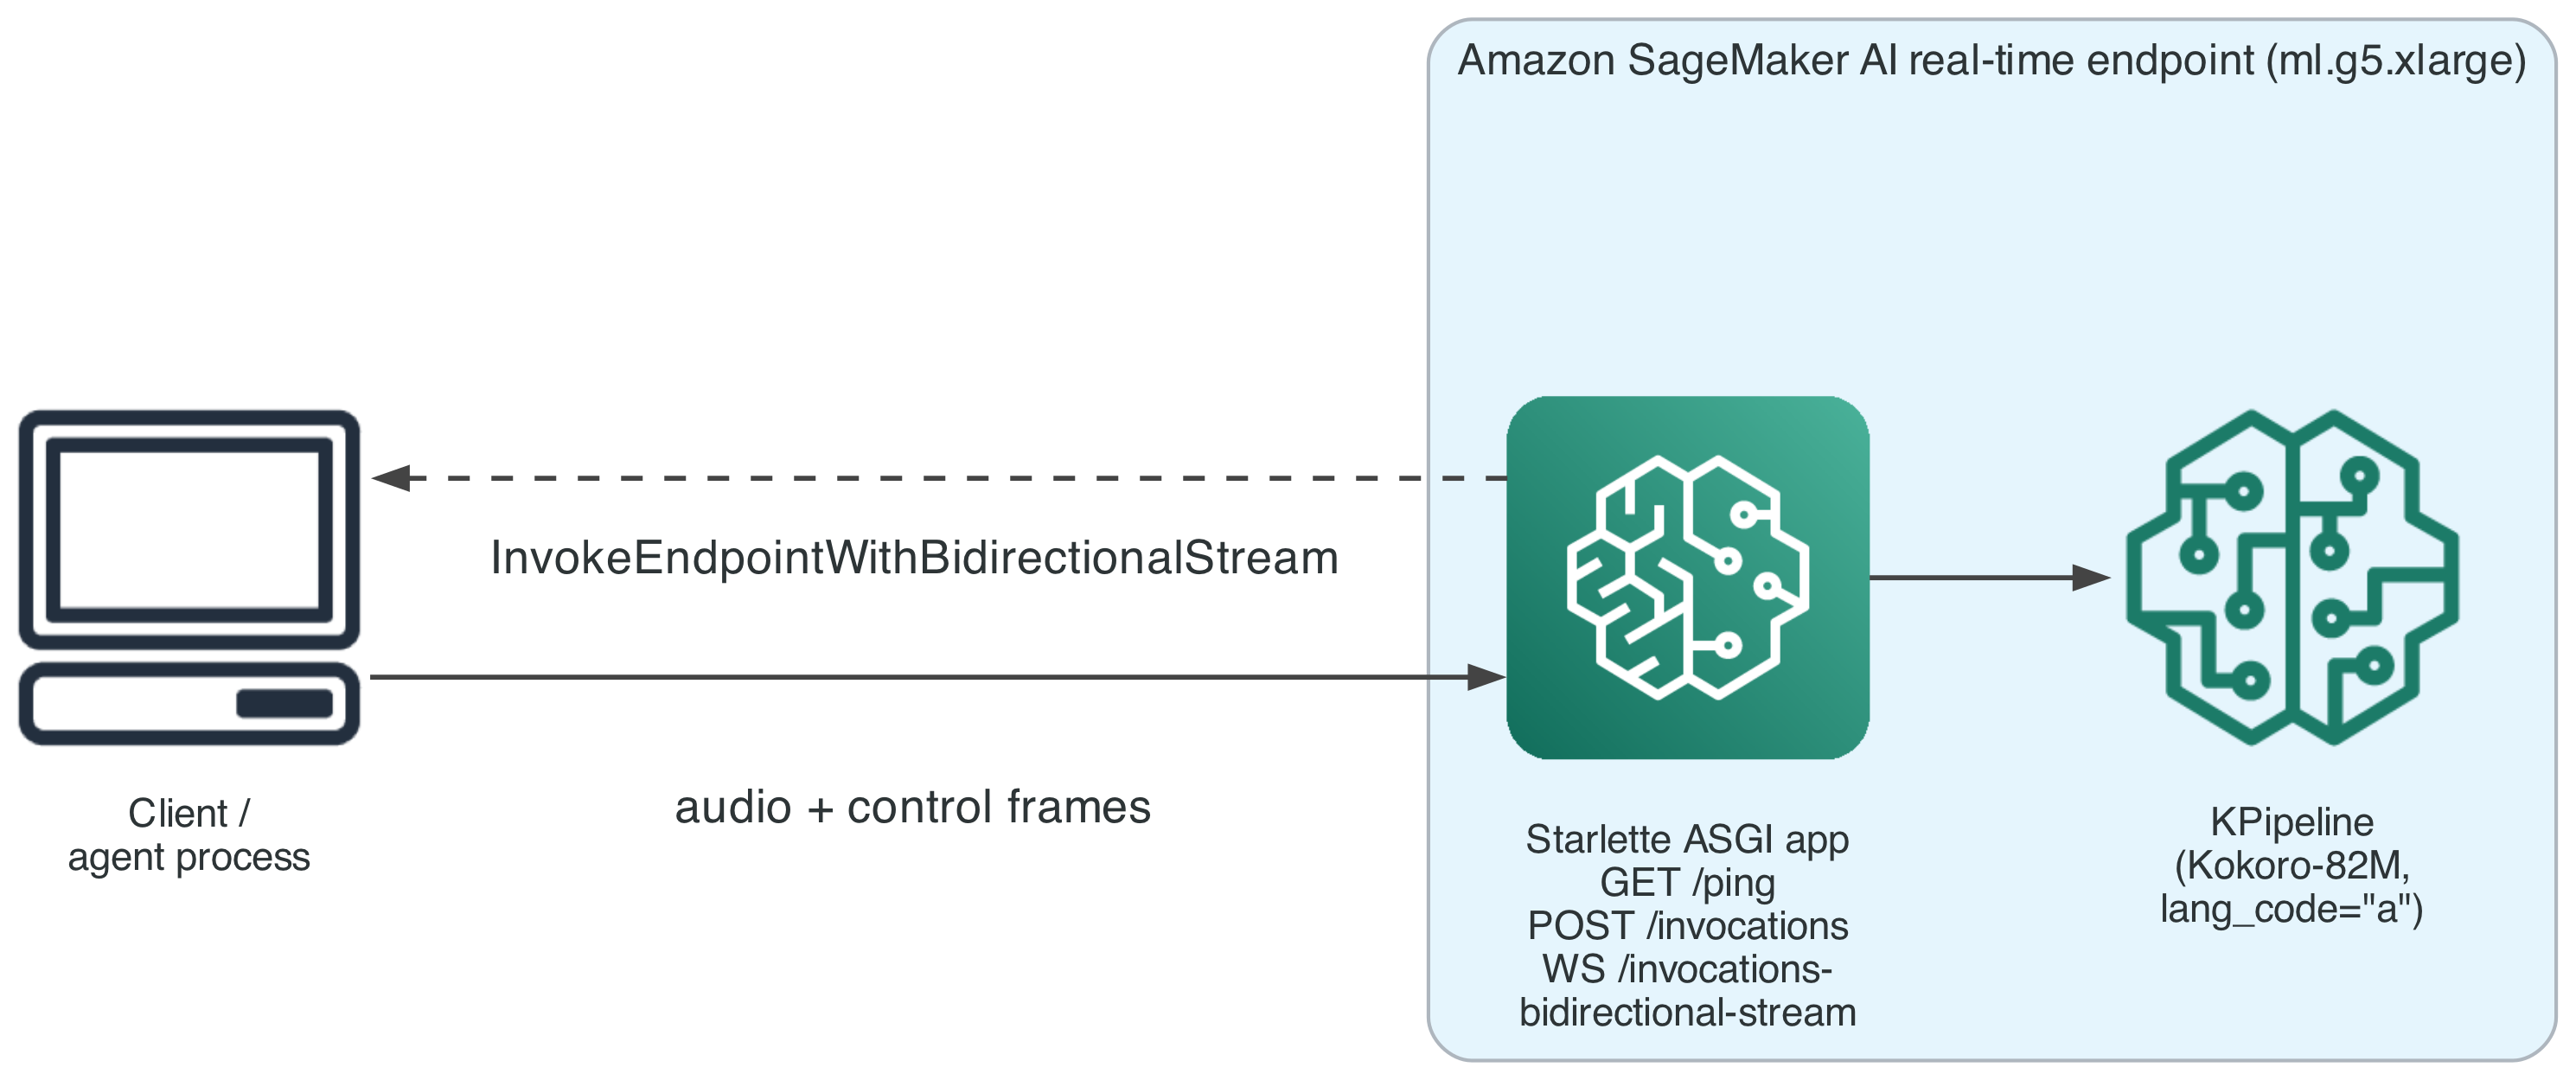
Amazon SageMaker AI를 활용하여 Kokoro-82M 텍스트-음성 변환(TTS) 모델을 즉시 스트리밍함으로써 음성 합성은 에이전트가 문장을 생성하는 즉시 시작될 수 있습니다. 이를 통해 사용자는 전체 응답이 완료될 때까지 기다릴 필요 없이 처음 문장의 합성 음성을 즉시 들을 수 있습니다.
Kokoro-82M은 ml.g5.xlarge GPU 인스턴스에서 SageMaker AI 실시간 엔드포인트로 호스팅되며, 두 가지 경로(POST /invocations 및 WS /invocations-bidirectional-stream)를 제공합니다. 이 경로는 오디오와 제어 프레임을 동일한 연결로 반환합니다.
필수 조건
- SageMaker AI 엔드포인트를 생성하기 위한 AWS 계정
- Python 3.12 이상, Docker, AWS SDK for Python(Boto3)
- GitHub 저장소에서 배포 코드
단계별 안내
- 엔드포인트 및 에이전트 배포
- WebSocket 프레임 유형 처리
- 세션을 메시지 간에 열어 두기
- 에이전트가 문장을 생성하는 즉시 스트리밍 시작
- 실제 에이전트에서의 구현
단계별 지침을 따라 구현하면, 문장 생성과 동시에 음성 합성이 시작되어 고객 경험이 개선됩니다.
결론
AI 음성 에이전트의 응답 지연을 줄이는 것이 사용자 경험 향상에 얼마나 중요한지를 살펴보았습니다. 이러한 방법을 통해 음성 합성 시작 시간을 크게 줄일 수 있었으며, Amazon SageMaker AI와 Kokoro TTS를 활용한 솔루션으로 쉽게 구현할 수 있었습니다. 자세한 내용은 아래 링크에서 확인하시기 바랍니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기