AWS에서 제공하는 'vLLM'은 대형 언어 모델을 위한 오픈 소스 추론 및 서빙 엔진으로, 크게 사전 로딩(prefill)과 디코딩(decode) 두 가지 단계로 구성된다. 이 두 단계는 서로 다른 컴퓨팅, 메모리 및 확장 특성을 지니고 있으며, 이를 효율적으로 관리하기 위해 AWS는 프리필/디코드 단계의 '분리'(disaggregation)를 도입하여 자원 활용도를 높이고 처리량과 지연 시간을 개선했다.
기존의 풀 기반 모델에서는 사후 처리 단계에서 키-값(KV) 캐시를 디코드 인스턴스로 전송하는 데 시간이 소요되며, 이는 첫 토큰 발생 시간(TTFT)에 영향을 미쳤다. 새롭게 도입된 푸시 기반 NIXL 커넥터는 사전 로딩 단계에서 디코드 사이드 블록 할당 및 등록을 겹쳐, 사후 프리필 경로를 단축시켜 TTFT와 출력 토큰 당 시간(TPOT)을 개선하는 역할을 한다.
아래는 푸시 기반의 KV 전송 아키텍처를 보여주는 간단한 이미지이다. 이를 통해 디코드 인스턴스, 프리필 인스턴스, 그리고 백그라운드 전송 스레드가 어떻게 협력하는지 설명한다.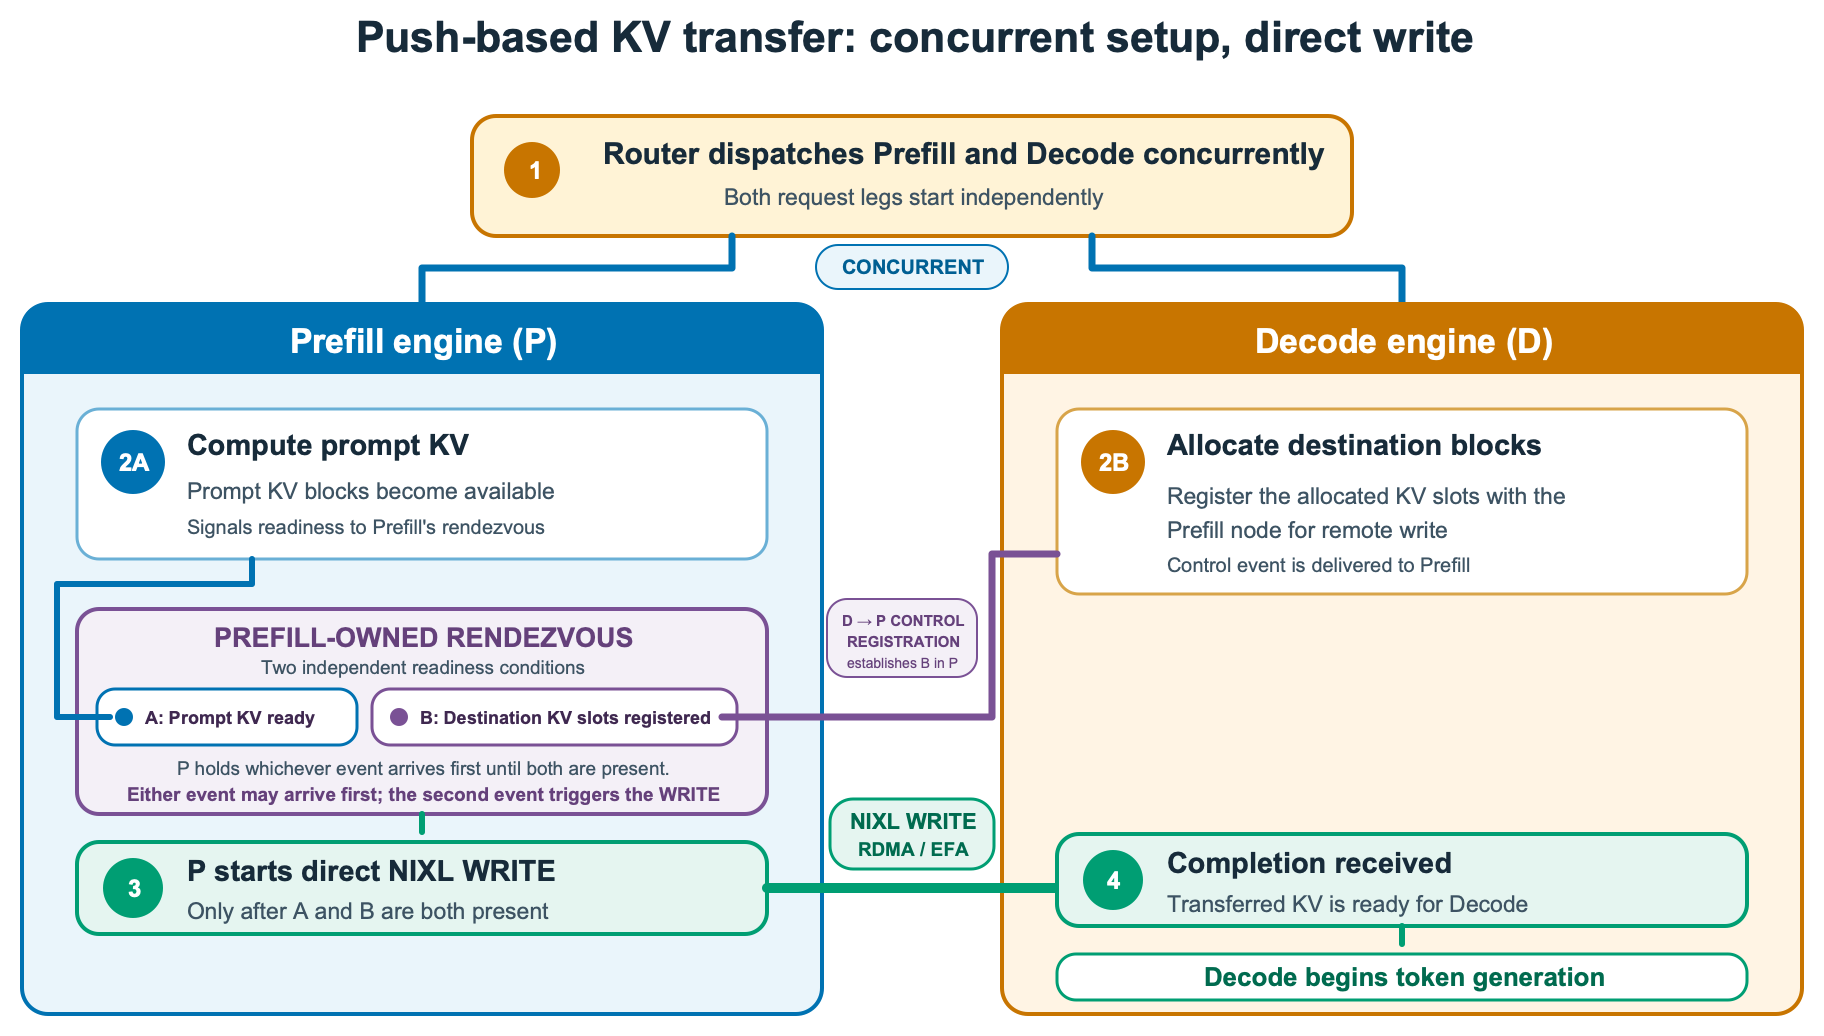
구현 과정에서는 디코드 인스턴스가 로컬 블록을 할당하고, 프리필 인스턴스에 NIXL 알림을 통해 등록한다. 푸시 모드를 사용하면 디코드 사이드에서의 설정과 프리필을 겹쳐놓아 첫 토큰까지 걸리는 시간이 크게 줄어든다. AWS EC2 P5en 인스턴스와 EFA를 연결해 Qwen3-32B 모델로 벤치마크를 수행한 결과, 푸시 모드는 풀 모드 대비 최대 3배의 TTFT 개선과 30%의 TPOT 개선을 보여주었다.
결론적으로, 푸시 모드는 초기 디코드 노드 선택이 가능하고 TTFT 개선이 우선시되는 경우에 적합하며, 사용자는 자신의 배포 환경에 맞는 모드를 선택하여 활용할 수 있다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기