AWS SageMaker에서 llama.cpp를 사용하여 의사 결정 모델 배포하기
최근에는 다양한 AI 솔루션들이 기업의 비즈니스에 중요한 역할을 하고 있습니다. 오늘은 이와 관련하여 AWS SageMaker를 활용하여 llama.cpp와 함께 의사 결정 모델을 어떻게 효과적으로 배포할 수 있는지에 대해 살펴보겠습니다. 이를 통해 AWS Deep Learning Containers(DLC)의 한층 강화된 활용법과 동시에 서비스를 최적화할 수 있는 방법을 알아보겠습니다.
의사 결정 모델의 배포와 활용 사례
현재의 애플리케이션은 요청을 라우팅하거나 에이전트 행동을 선택하며, 고정된 선택지 세트를 통해 정책 결과를 할당하는 것이 요구되기도 합니다. 이러한 의사 결정 모델을 AWS SageMaker AI AWS SageMaker AI로 배포하면, CPU 및 GPU 인프라에서 정량화된 모델을 관리할 수 있습니다.
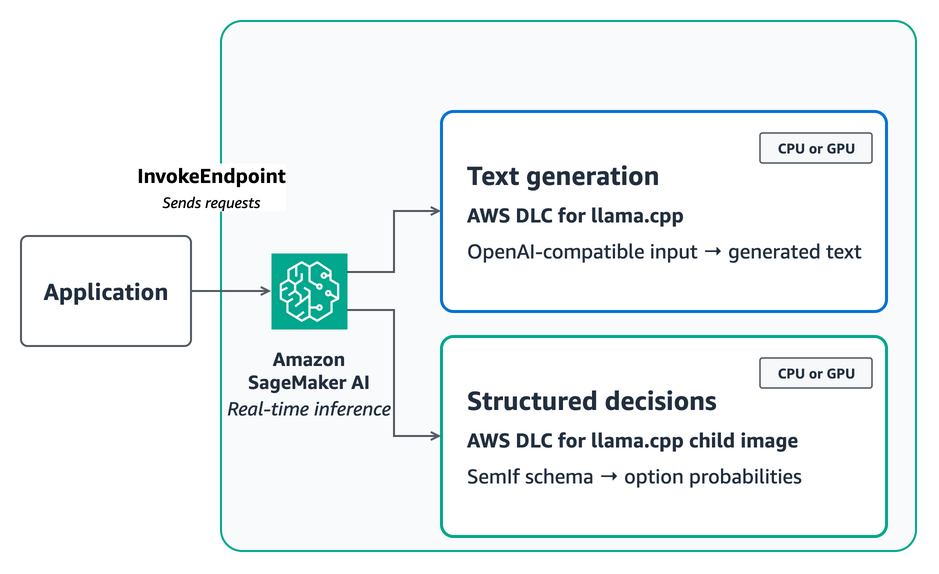
llama.cpp를 사용하여 의사 결정 모델을 Amazon SageMaker AI의 Endpoint를 통해 제공할 수 있으며, 이는 OpenAI 호환형 채팅 완료(Z)의 기능을 확장하여 SemIf로 반환하여 선택된 옵션에 대한 확률을 제공합니다. 해당 작업은 CPU 또는 GPU에서 실행될 수 있으며, 각각의 필요에 맞추어 실행 전략을 조절할 수 있습니다.
적용 및 최적화 전략
Amazon SageMaker AI는 텍스트 생성 경로와 구조적 결정 경로라는 두 가지 배포 경로를 제공하며, 각각 OpenAI 호환 API를 통해 응답을 반환합니다. AWS의 특정 요건에 따라 CodeBuild를 사용하여 SageMaker에 맞는 어댑터를 갖춘 새로운 이미지 생성도 가능합니다.
- 텍스트 생성 경로: OpenAI 호환 API를 사용하여 생성된 응답을 반환합니다.
- 구조적 결정 경로: 각 옵션에 대한 확률을 반환하는 SemIf 어댑터를 사용합니다.
애플리케이션 요구에 따라서, 텍스트 생성이 필요하거나 모델 상태 작업이 직접적으로 요구되는 경우 SemIf 어댑터를 활용할 수 있습니다. 여기서 CPU는 지연 민감도가 낮은 작업을 처리하는 것이 적합하며, GPU는 프롬프트 전립 및 테일 지연 시간이 애플리케이션 경험에 영향을 주는 경우 선호됩니다.
최종적으로 AWS DLC for llama.cpp는 CPU 및 GPU 인스턴스를 활용하여 의사 결정 모델을 배포하는 방식을 지원하며, OpenAI 호환 채팅 커플레이션을 통해 제공될 수 있습니다.
보다 자세한 배포 안내는 여기에서 확인하실 수 있습니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기