Amazon EKS에서 멀티 노드 인퍼런스 배포 방법
클라우드 컴퓨팅의 발전과 함께 대규모 언어 모델(LLM)을 활용하기 위한 인프라 구성은 필수가 되었습니다. 이번 글에서는 Amazon Elastic Kubernetes Service(Amazon EKS)를 통해 대규모 언어 모델을 두 개의 GPU 노드에 걸쳐 배포하는 방법을 소개합니다.
배포 가이드
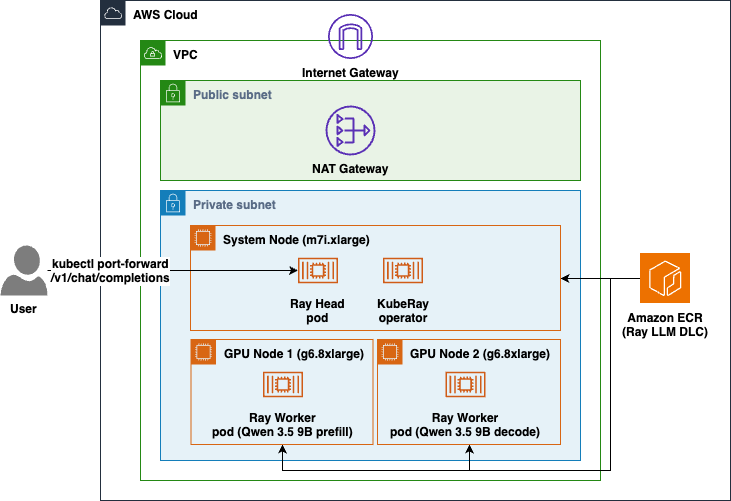
이번 포스트에서는 여러 노드에 걸쳐 Ray LLM 딥러닝 컨테이너(Ray LLM Deep Learning Containers)를 사용하여 인퍼런스를 수행하는 방법을 설명합니다. Ray Serve를 활용하면 여러 노드에 걸쳐 인퍼런스를 배포할 수 있으며, 특히 큰 모델의 관리나 고속 처리에 유리한 구조를 제공합니다.
사전 요구 사항
- AWS 계정 및 g6.8xlarge 인스턴스를 실행할 수 있는 서비스 쿼터
- AWS CLI, kubectl, eksctl, helm, envsubst 등의 도구
단계별 구현
- EKS 클러스터 생성: VPC 및 서브넷 구성 후, KubeRay 운영자와 Ray 헤드를 위한 CPU 시스템 노드 그룹을 설정합니다.
- GPU 워커 노드 추가: 두 개의 g6.8xlarge 인스턴스를 추가하여 GPU 워커 노드를 설정하고, EFA(Elastic Fabric Adapter)를 활성화 합니다.
- KubeRay 운영자 설치: Helm을 사용하여 GPU 노드에 추가적인 로드가 없도록 CPU 시스템 노드 그룹에 운영자를 설치합니다.
- RayService 배포: Ray Serve LLM 어플리케이션을 통해 모델을 배포합니다. 이 때, prefill과 decode 작업을 분리하여 각 GPU 노드에서 처리합니다.
결론 및 다음 단계
Ray LLM Deep Learning Containers를 사용하여 대규모 언어 모델을 두 개의 GPU 노드에 걸쳐 성공적으로 배포 및 실행했습니다. 이 과정은 YAML 블록만으로 구성된 구조이기 때문에 복잡한 코드 작성 없이도 가능합니다. 이를 기반으로 더 큰 모델이나 추가 라이브러리를 사용하여 확장할 수도 있습니다.
상세한 코드 및 추가 정보는 다음 링크에서 확인할 수 있습니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기