AWS SageMaker AI와 vLLM-Omni를 활용한 실시간 음성 애플리케이션 구축
서론
현대의 음성 에이전트와 대화형 학습 애플리케이션은 사용자 경험을 개선하기 위해 실시간으로 반응하는 것이 중요합니다. 이 블로그 글에서는 AWS SageMaker AI와 vLLM-Omni를 이용하여, 음성합성(TTS) 모델을 배포하는 방법을 소개합니다. 특히, vLLM-Omni를 통해 Amazon SageMaker AI에서 텍스트를 입력받아 실시간으로 오디오를 생성하는 과정을 중점적으로 살펴봅니다.
본문
1. vLLM-Omni와 SageMaker AI의 활용
AWS의 vLLM-Omni는 텍스트 생성 외 다중 모달 모델에도 적용 가능한 인프라를 제공합니다. 음성, 이미지, 비디오와 같은 다양한 데이터를 처리하며, SageMaker AI와의 통합을 통해 강력한 멀티미디어 응용 프로그램을 지원합니다.
2. 실시간 음성 전송의 사례
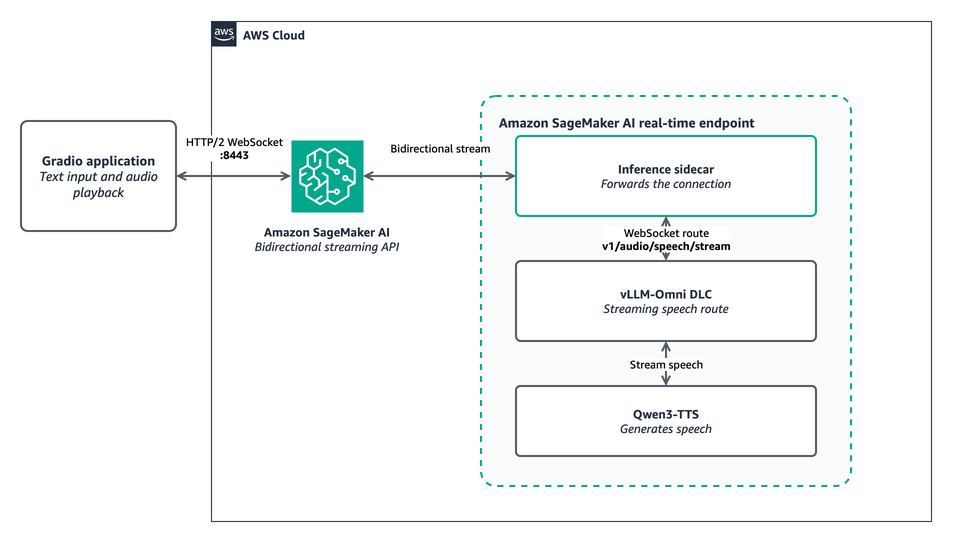
음성 전송이 중요한 현대 환경에서는, Qwen3-TTS 모델과 같은 최신 모델을 활용한 스트리밍이 가능합니다. SageMaker의 이중 스트리밍 기능을 사용하여 웹소켓을 통해 실시간으로 텍스트를 오디오로 변환할 수 있습니다.
3. 실제 배포 가이드
- Github에서 샘플 리퍼지토리 복제
- 필요한 파이썬 패키지 설치
- SageMaker AI 실행 역할 설정
- Qwen3-TTS 모델 배포 및 Gradio 애플리케이션 테스트
실제로 코드 예제를 통해 사용하는 방법은 GitHub 코딩 예제를 참조하여 이해를 도모할 수 있습니다.
결론
전반적으로 AWS vLLM-Omni DLC를 이용한 이러한 접근 방식은 다양한 모달의 데이터를 실시간으로 처리하고 스트리밍하는데 적합합니다. 또한 이 방법은 이전의 vLLM 음성 인식 예제와 결합하여, 마이크 오디오를 텍스트로 변환하고 이를 다시 음성으로 스트리밍하는 방식을 보여줍니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기