AWS의 Amazon SageMaker HyperPod를 활용한 다지역 학습 전략
AWS가 제공하는 Amazon SageMaker HyperPod는 대규모 AI 모델 학습에 최적화된 솔루션으로, 특히 데이터 및 컴퓨팅 리소스가 다른 지역에 분포되는 경우 큰 효율성을 제공합니다. 이번 블로그에서는 Amazon SageMaker HyperPod를 사용해 어떻게 다지역에서도 효율적인 AI 학습을 진행할 수 있는지에 대해 설명하고, 이를 뒷받침하는 실제 사례를 소개합니다.
비용 효율성 및 성능 최적화가 AI 학습의 가장 중요한 요소 중 하나인데, 많은 기업들이 대형 GPU 용량을 사용하면서도 데이터와 컴퓨팅 자원이 늘 같은 지역에 위치하지 않는 문제를 겪습니다. Amazon SageMaker HyperPod와 Qumulo의 클라우드 네이티브 데이터 솔루션을 결합하면, 성능을 유지하면서도 데이터 복제의 과정을 피하고 네트워크 지연 시간을 감소시킬 수 있습니다.
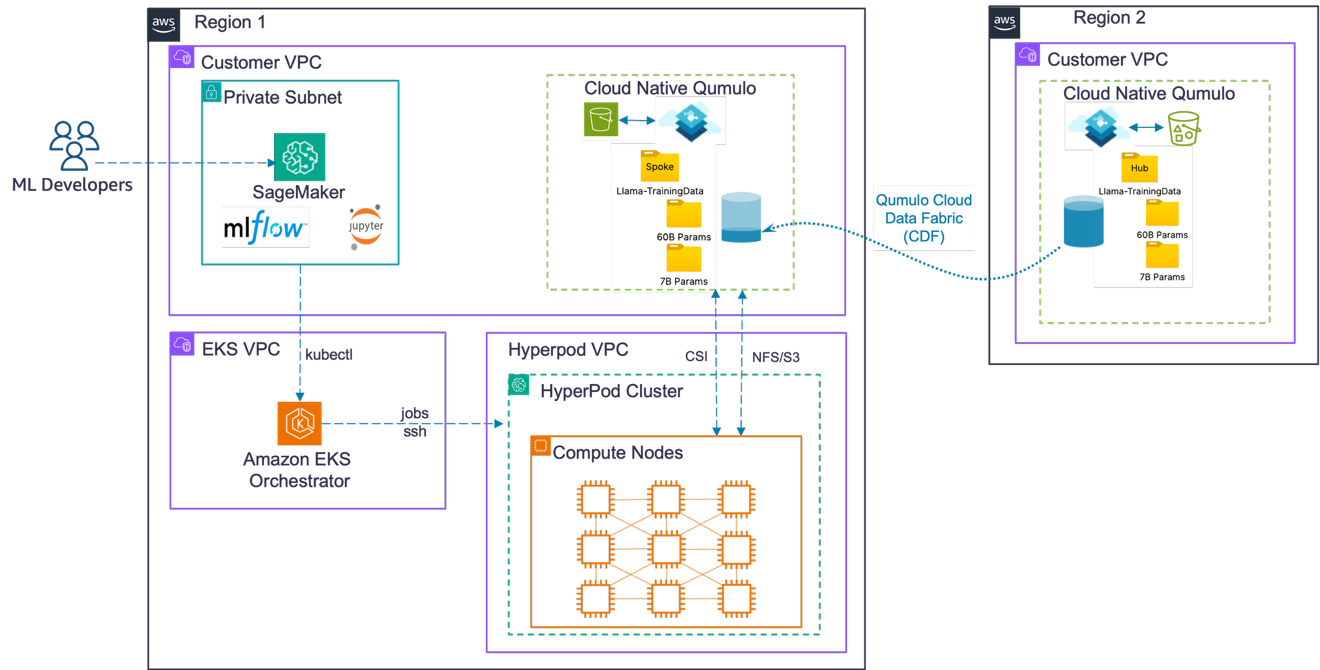
HyperPod와 Qumulo: 다지역 학습 솔루션
이 솔루션을 통해 Amazon Qumulo와 Cloud Data Fabric을 결합하여, 데이터 복사나 코드 변경 없이도 다른 AWS 지역이나 온프레미스에서 데이터를 불러오고 처리할 수 있습니다.
솔루션의 주요 성능
- 단일 지역 내 학습 성능: CNQ의 클라우드 네이티브 구조는 데이터 저장 크기와 무관하게 성능을 독립적으로 확장하여 99%의 GPU 활용률을 실현합니다.
- 최적의 원격 클러스터 학습: 데이터와 다른 지역에서 작동하는 HyperPod 클러스터도, 동일한 수준의 처리량을 획득할 수 있습니다. 이 성능은 첫 100~150 배치 시에는 약간의 워밍업 시간이 필요할 수 있지만, 대규모 학습에서는 무시할 수 있는 수준입니다.
실제 사례 분석
동일한 학습 작업이 두 클러스터에서 독립적으로 실행되었습니다. 허브 클러스터는 US 동부(오하이오) 지역에 위치하고, 데이터를 로컬에서 처리합니다. 반면 스포크 클러스터는 US 서부(오리건) 지역에 배치되어 60ms의 네트워크 지연 시간을 통해 데이터를 원격으로 액세스했습니다. 그 결과, 스포크 클러스터는 허브와 동일한 성능을 보여주었으며 이는 성능 유지와 동시에 데이터 이동 없이도 효율적인 학습이 가능하다는 것을 시사합니다.
결론
다지역에서도 데이터를 복사하지 않고 고성능 AI 학습을 실행하려는 기업에게 Amazon SageMaker HyperPod와 Qumulo 솔루션은 강력한 무기가 될 것입니다. 클래식 아키텍처에서 벗어나, 동일한 데이터 세트를 여러 지역에서 동시에 사용할 수 있게 되면서 더 효율적이고 경제적인 AI 모델 학습이 가능해졌습니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기