AWS를 활용한 대규모 강화 학습 최적화 방식
도입부:
AWS의 인공지능(AI) 솔루션은 대규모 강화 학습(RL) 작업을 효율적으로 관리하고 최적화하는 데 중요한 역할을 하고 있습니다. 특히, Amazon Elastic Kubernetes Service(Amazon EKS), Elastic Fabric Adapter(EFA), DeepEP을 활용한 구성은 대규모 RL 작업에서 발생하는 멀티워크로드 최적화 문제를 해결하는 데 많은 도움을 줍니다. 이 글에서는 Amazon EKS와 다른 AWS 서비스들을 활용하여 대규모 RL 환경에서 발생하는 주요 문제를 해결하는 방법에 대해 살펴봅니다.
본문: 주요 내용 및 사례
대규모 RL 학습은 일반적인 머신 러닝보다 뛰어난 인프라가 필요합니다. 특히 Mixture-of-Experts(MoE) 모델은 전문가 간의 동적 통신으로 인해 고도의 병렬 처리 및 네트워크 관리가 필수적입니다. MoE는 수백만 개의 매개 변수를 효율적으로 다루기 위한 대표적인 아키텍처로 자리잡고 있으며, 이 과정에서의 스케일링은 중요합니다.
아래 다이어그램은 Amazon EKS와 EFA, Amazon S3를 조합하여 롤아웃-트레이닝 루프를 구성하는 방법을 보여줍니다. 이는 대규모 분산 RL 작업에서 발생하는 롤아웃 생성과 정책 학습의 요구를 신속하게 충족시킬 수 있는 강력한 구성을 제공합니다.
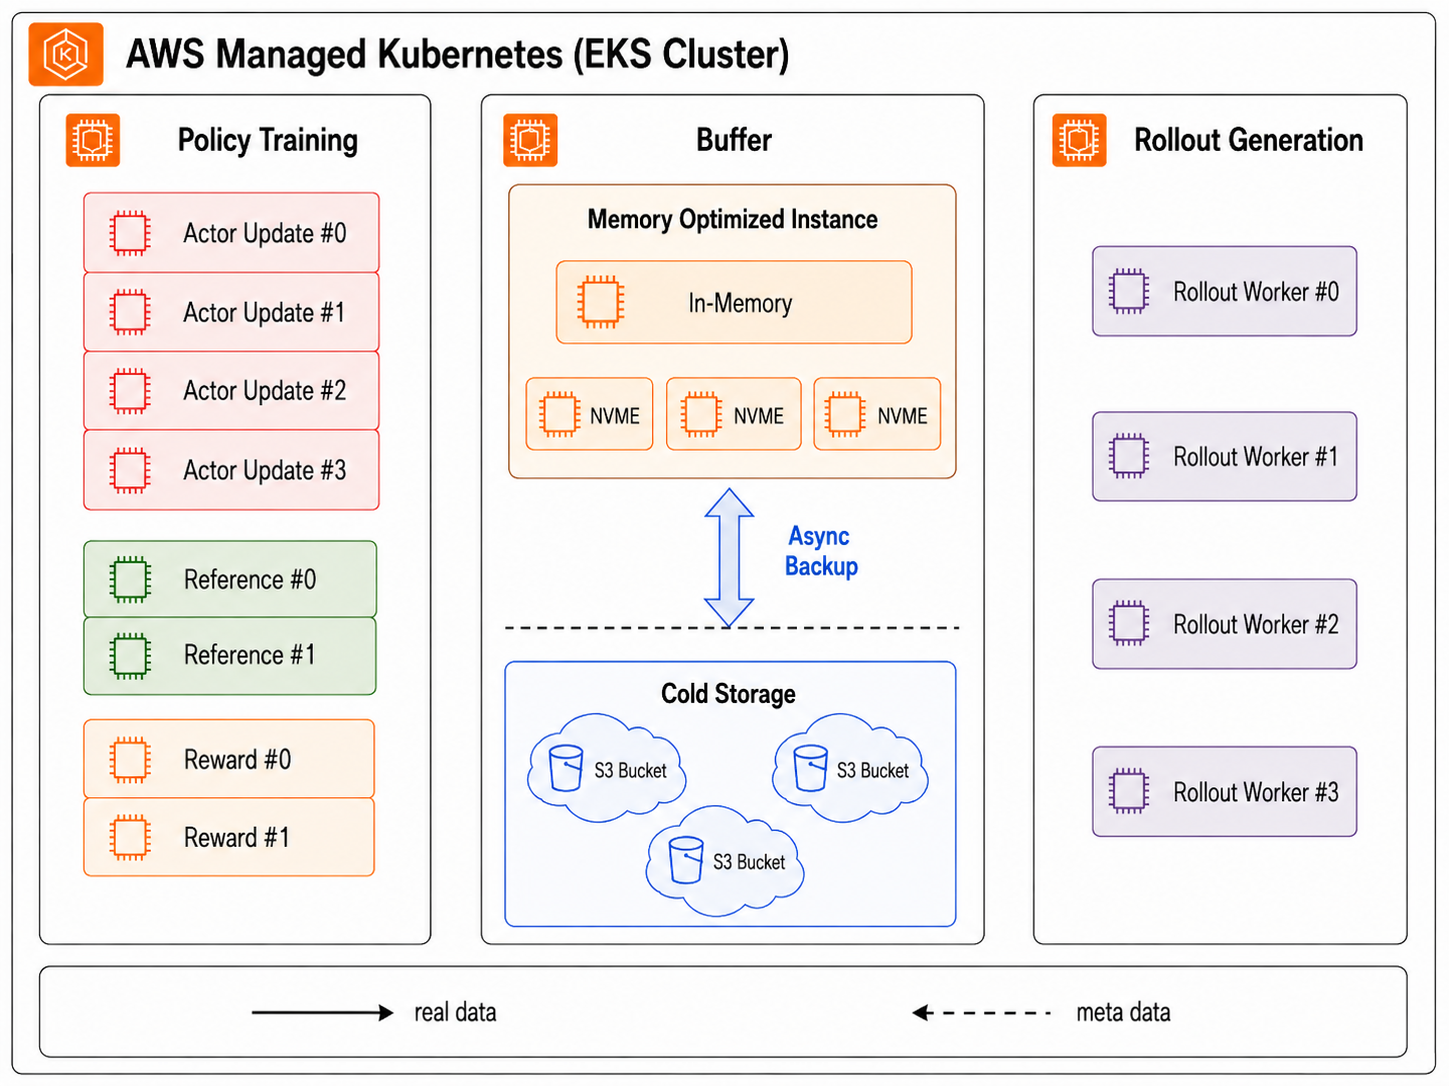
이 환경에서는 EKS 클러스터 내의 GPU, CPU, 메모리 최적화 노드 그룹을 통해 RL 워크플로우 각 단계를 최적으로 수행할 수 있도록 구성되어 있습니다. EFA를 통해 고성능 네트워크 통신을 지원하고, Amazon S3를 통해 데이터를 안전하게 저장하고 관리할 수 있습니다.
특히, MoE 아키텍처에서 EFA를 통한 DeepEP 적용은 전송 계층을 최적화하여 전문 병렬 통신 오버헤드를 줄여주며 RL 작업의 효율을 40% 이상 향상시킬 수 있었습니다. 이는 대규모 분산 환경의 병목을 줄이면서 성능을 극대화하는 데 큰 기여를 합니다.
결론:
AWS와 오픈 소스 구성 요소는 대규모 MoE RL 작업을 강력한 성능과 비용 효율성으로 운영할 수 있게 해줍니다. 이 글에서 소개한 아키텍처 패턴을 참조하여 AWS의 EKS와 EFA를 활용한 MoE 작업을 여러분의 업무에 맞춰 작성해 볼 수 있습니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기