AWS SageMaker를 활용한 AI 모델 배포 및 운영 가이드
소개
현대 AI 개발 환경에서 AWS SageMaker는 AI 모델의 배포와 운영을 단순화하는 강력한 도구로 자리잡았습니다. 이 블로그에서는 AWS SageMaker를 활용하여 AI 모델을 보다 효율적으로 배포 및 운영하는 방법과 주요 기능들에 대해 살펴봅니다. 이 글은 구체적인 활용 사례와 함께 모델 배포 가이드, 자동화, SEO 키워드를 포함하여 더욱 효율적인 AI 인프라 운영을 위한 이해를 돕고자 합니다.
본문
AWS SageMaker의 다양한 기능을 통해 AI 모델의 배포 과정을 자동화하고 효율적으로 관리할 수 있습니다. 특히 AI 모델을 대규모로 배포해야 하는 환경에서는 SageMaker가 제공하는 다양한 옵션들을 적절하게 활용하는 것이 중요합니다.
Key 기능과 활용 사례
-
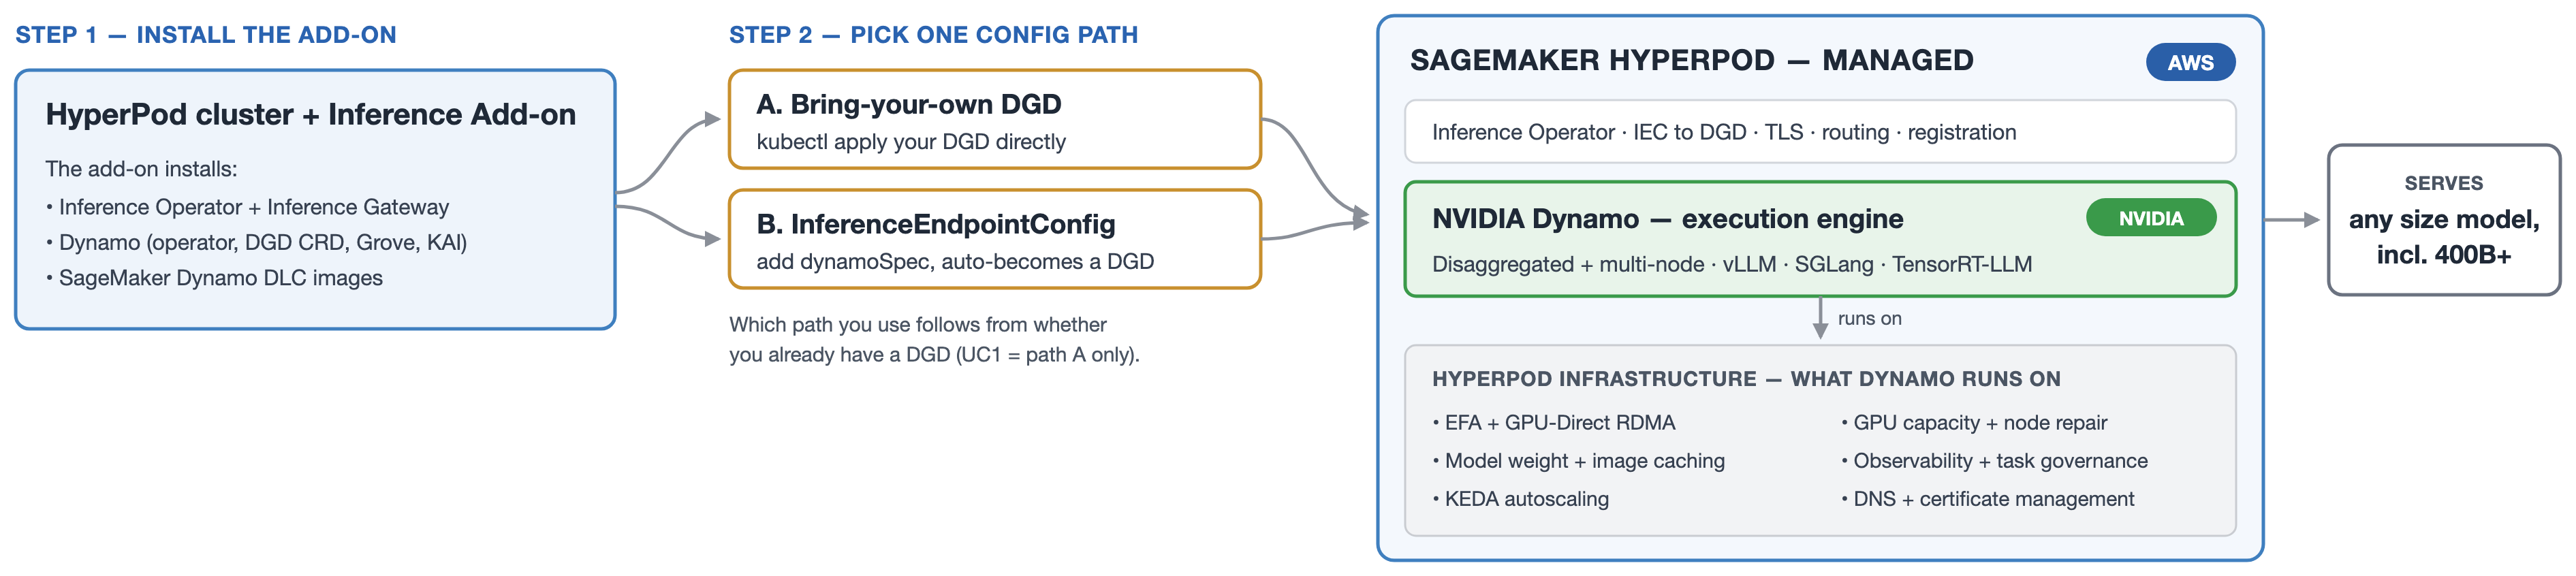
HyperPod Inference: 다중 노드 제공 프레임워크를 통해 대규모 모델도 효과적으로 배포할 수 있습니다. NVIDIA Dynamo와 같은 프레임워크가 포함되어 있어, 모델을 여러 노드에 분산하여 처리할 수 있습니다.
-
SageMaker Inference Gateway: GPU 상태를 실시간으로 모니터링하여 요청을 가장 적합한 노드로 라우팅하는 기능입니다. 이는 큐 대기 시간을 줄이고 GPU의 사용 효율을 극대화합니다.
-
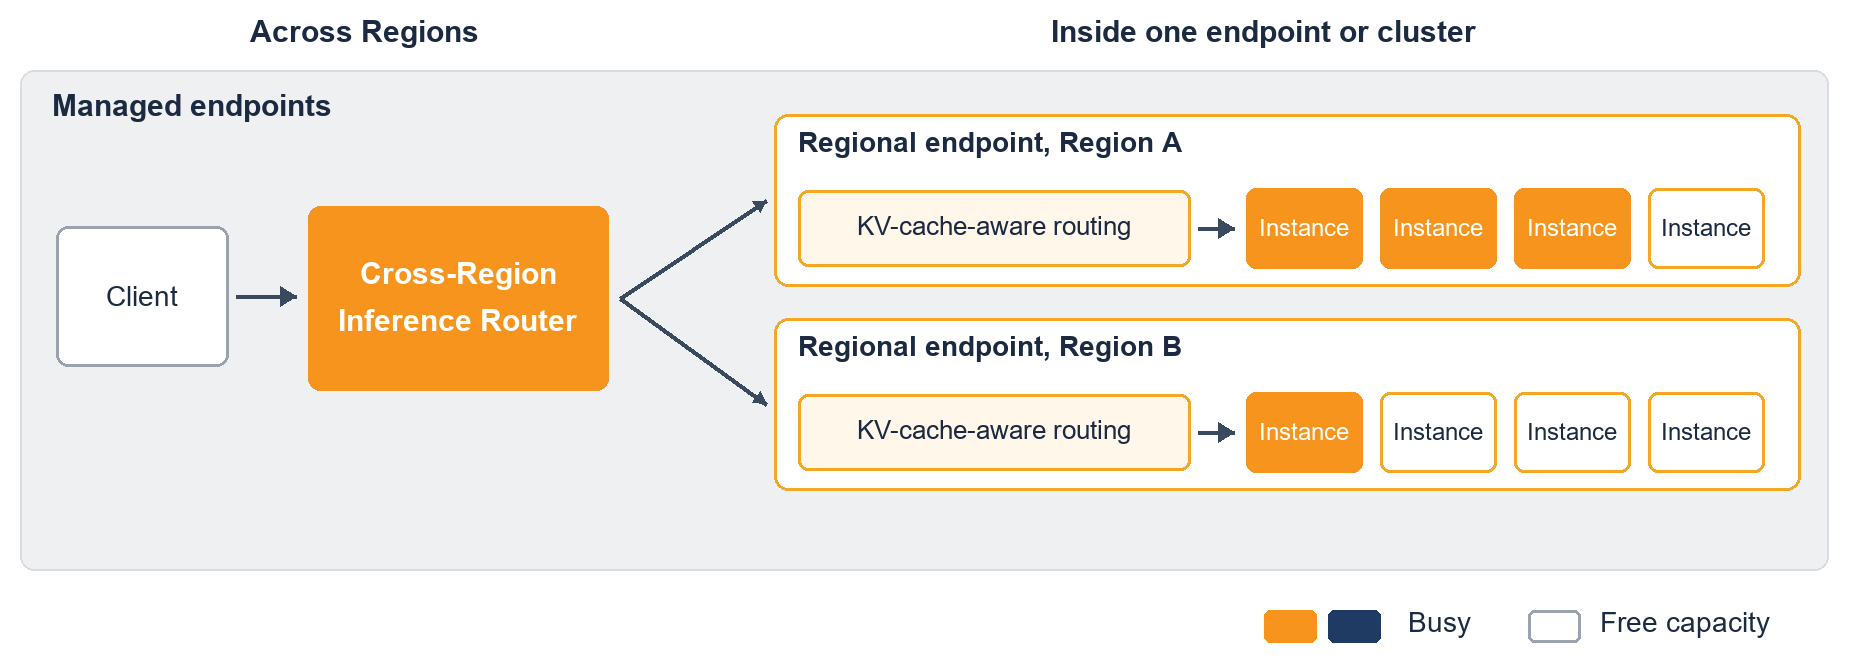
KV-Cache Aware Routing: 길이가 긴 프롬프트를 효율적으로 처리할 수 있게 함으로써 응답 속도를 크게 향상시킵니다.
-
Cross-Region Inference Routing: 여러 지역에 분산된 AI 인프라에서 요청을 가장 적합한 인스턴스로 라우팅할 수 있습니다. 이를 통해 지역적인 병목 현상을 완화하고, 리소스를 최적화할 수 있습니다.
활용 사례
대규모 고객 지원 어시스턴트 모델을 운영 중인 한 팀은, SageMaker의 다양한 기능을 활용하여 70B 파라미터의 모델을 단일 엔드포인트에서 실행하고 있습니다. 이들은 GPU 메모리를 최적화 하고 네트워크 비용을 절감하기 위해, 다중지역 네트워크를 확장하였습니다.
결론
AWS SageMaker는 AI 모델 배포와 운영의 효율성을 크게 향상시킬 수 있는 다양한 도구와 기능을 제공합니다. 이를 통해 기업들은 AI 모델의 배포 속도를 높이고 비용을 절감할 수 있으며, 확장 가능한 아키텍처로 AI의 전체적인 성능을 극대화할 수 있습니다. 이러한 도입은 AI 기반 솔루션이 지속적으로 경쟁력을 갖추는데 필수적입니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기