Amazon Bedrock를 활용한 웹 콘텐츠 준비 방법
소개
오늘날 기업들은 Amazon Bedrock와 같은 완전 관리형 솔루션을 통해 클라우드 기반의 RAG(Retrieval Augmented Generation) 애플리케이션을 구축하고 있습니다. 이번 글에서는 Amazon Bedrock Knowledge Base와 Crawl4AI를 사용하여 웹 콘텐츠를 준비하는 방법을 소개합니다. 주로 데이터 소스 연결과 자동화된 처리 과정에 대해 설명합니다.
본문
Amazon Bedrock Knowledge Base의 활용
Amazon Bedrock를 사용하면 데이터 소스를 연결하여 데이터의 수집, 저장, 인덱싱 및 검색을 관리할 수 있습니다. 특히, 웹 콘텐츠를 위한 데이터 소스 커넥터로 Amazon Bedrock Web Crawler를 시작하는 것이 일반적입니다. 이 과정에서, Crawl4AI라는 오픈 소스 Python 크롤러와 통합하여 더 복잡한 준비 과정을 자동화할 수 있습니다.
도입 사례: Crawl4AI로 확장하기
Crawl4AI는 웹 콘텐츠를 보다 세밀하게 컨트롤할 수 있는 기능을 제공합니다. 예를 들어, 각 페이지의 주요 콘텐츠 부분만 인덱싱하거나, 사용자가 제공한 메타데이터 속성을 문서에 연결할 수 있습니다. 이러한 방식으로 준비된 데이터를 Amazon S3에 저장하고, Amazon Bedrock Knowledge Base로의 자동화된 수집과 인덱싱이 가능합니다.
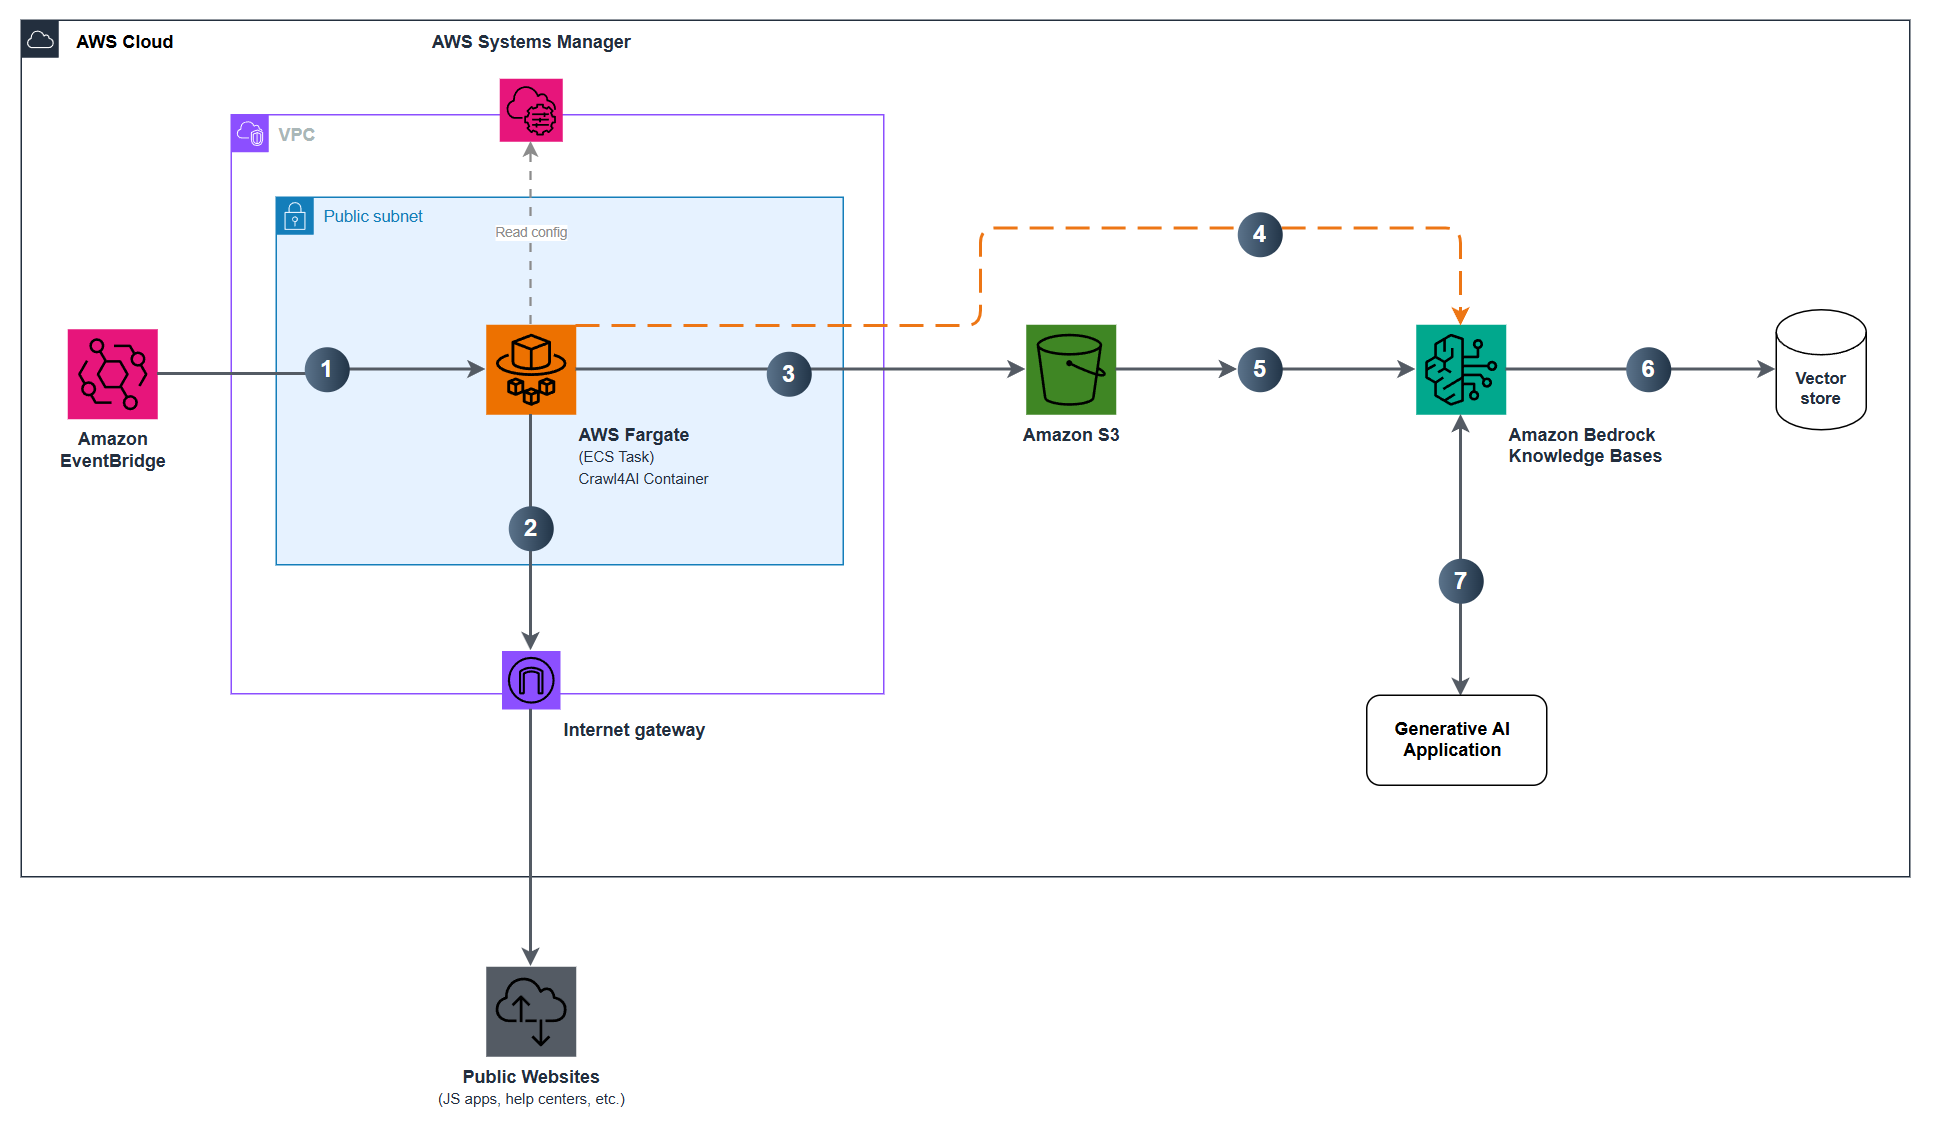
- 이벤트 브리지(Amazon EventBridge)가 ECS 태스크를 시작합니다.
- 태스크가 웹사이트를 크롤링하고, 각 페이지에 대해 Markdown 파일과 메타데이터를 준비합니다.
- 준비된 파일을 S3 버킷에 업로드합니다.
- Knowledge Base 수집 작업을 시작합니다.
- Amazon Bedrock는 새로운 데이터를 읽고, 파싱 및 인덱싱을 관리합니다.
Crawl4AI의 배포
AWS CDK를 사용하여 자동화된 워크플로우를 구축하고 배포할 수 있습니다. 워크스테이션에 필요한 도구를 설치하고 CloudFormation 스택을 통해 해당 작업을 자동화할 수 있습니다. 공용 웹사이트를 대상으로 콘텐츠를 준비할 때 신뢰할 수 있는 대상만 선택해야 하며, 각 단계에서 보안을 강화하는 것이 필요합니다.
결론
Amazon Bedrock 및 Crawl4AI는 복잡한 웹 데이터 준비를 자동화하여 더 나은 데이터 검색 품질을 제공합니다. 이러한 도구들은 기업이 클라우드 내에서 데이터를 효과적으로 관리할 수 있도록 지원하며, 다양한 웹 데이터 소스를 쉽게 통합할 수 있습니다. 시작하려면 sample-crawl4ai-bedrock-knowledge-base를 참고하여 초기 설정 및 테스트 과정을 수행하세요.
[1] 원문 URL: [https://aws.amazon.com/blogs/machine-learning/prepare-web-content-for-amazon-bedrock-knowledge-bases-with-crawl4ai/]
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기