AI 에이전트 배포 가이드: AWS에서 Reflection Beam 활용하기
최근 에이전트 AI 활용에 대한 관심이 급증하고 있습니다. 특히 코드 유지, 도구 활용, 결과 해석 등의 긴 호수 작업을 관리하는 데 있어 오픈 가중치 모델인 Reflection Beam은 많은 주목을 받고 있습니다. 본 블로그에서는 Reflection Beam이 어떻게 AWS에서 배포될 수 있는지, 그리고 이를 통해 얻을 수 있는 이점에 대해 다뤄보겠습니다.
Reflection Beam의 비전과 활용 방법
Reflection의 목표는 개방된 인텔리전스 모델을 통해 모든 사람에게 인공지능의 접근을 열어주는 것입니다. 이것은 개방형 모델 가중치, 공개 연구 및 오픈 소스 소프트웨어를 제공함으로써 달성됩니다. 이러한 접근 방식은 소프트웨어 공학 및 에이전트 시스템 구축에 크게 기여합니다. 특히 AWS와의 연계를 통해, 개발자들은 Amazon SageMaker JumpStart와 HyperPod Inference를 사용하여 Reflection Beam을 배포할 수 있습니다.
Reflection Beam은 소프트웨어 문제 해결, 코드 수정, 도구 호출 및 중간 결과 처리 역할을 수행하는 스파스 전문가 혼합 모델입니다. 5010억 개의 총 파라미터와 230억 개의 활성 파라미터를 갖추고 있어 강력한 AI 성능을 자랑합니다. 다음 이미지에서 Beam의 분산 배포 구조를 확인할 수 있습니다:
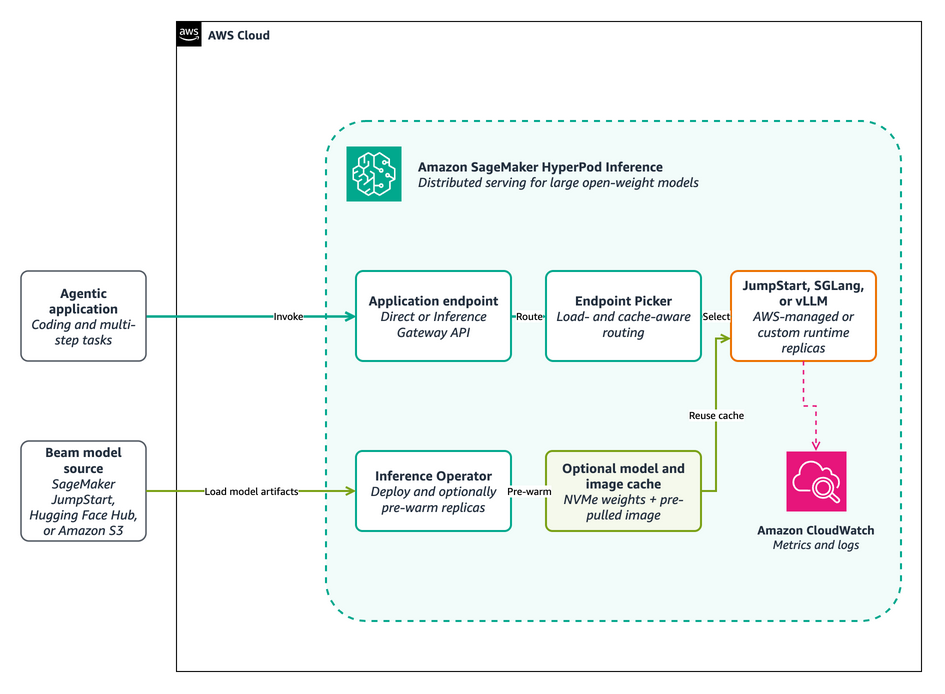
Reflection Beam 배포 가이드
AWS에서 Reflection Beam을 시작하려면 우선 Amazon SageMaker JumpStart 실시간 엔드포인트를 생성하는 것이 가장 간단한 방법입니다. Kubernetes를 직접 운영하지 않고도 AWS 관리 모델 패키지, 엔드포인트 및 호출 API를 사용할 수 있습니다. Kubernetes 네이티브의 제어가 필요할 경우, Amazon Elastic Kubernetes Service (Amazon EKS)와 HyperPod Inference를 통해 JumpStart에서 모델을 실행할 수 있습니다.
SageMaker JumpStart 실시간 경로는 모델, 컨테이너 및 엔드포인트를 관리 배포 워크플로우 뒤에 패키징합니다. 이 경로를 통해 클러스터와 실행 런타임을 제어할 수 있기 때문에 분산 실행, 캐싱, 라우팅, 확장을 완벽히 관리할 수 있습니다.
결론
Reflect Beam은 오픈 가중치 모델로, 에이전트 코딩 및 다단계 작업을 위한 개발자에게 독특한 솔루션을 제공합니다. SageMaker JumpStart 실시간 엔드포인트를 통해 완전 관리형 배포를 시작해 보세요. Kubernetes 네이티브 인프라 제어가 필요하다면 SageMaker HyperPod Inference를 활용하되, 서비스 컨테이너 관리는 피할 수 있습니다. 독자적인 실행 환경이 필요할 경우, SGLang이나 vLLM을 이용해보세요.
더 많은 정보 및 배포 가이드를 원하시면, Reflection AI의 비전을 살펴보시고, Introducing Beam을 통해 자세한 내용을 읽어보시기 바랍니다.
[1] https://reflection.ai/blog/introducing-beam
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기