AWS와 Amazon SageMaker AI를 활용한 고급 머신러닝 모델 최적화
AWS는 클라우드 컴퓨팅의 혁신을 이끄는 선두 주자로, 다양한 AI 및 머신러닝 모델의 개발과 최적화를 지원합니다. 최근에는 AWS를 통해 Mixture-of-Experts (MoE) 모델의 성능을 극대화하기 위한 고급 기술이 적용되어 주목받고 있습니다. 이러한 모델들은 거대 언어 모델(LLM)의 용량을 증가시키는 동시에, 토큰 당 컴퓨팅 비용을 절감하는 데 중점을 둡니다.
Fused MoE: 효율성을 높이는 기술
Fused MoE는 MoE 아키텍처를 최적화하기 위한 핵심 기술로, 토큰 라우팅, 데이터 셔플링, 네트워크 계산을 GPU에서 하나의 일괄 작업으로 병합합니다. 이 과정은 복잡하지만, 지연 시간을 줄이고 높은 GPU 활용도를 실현합니다. 이를 통해 사용자는 더 효율적인 모델 실행을 기대할 수 있습니다.
Hopper 아키텍처와 SWAP-AB 최적화
NVIDIA Hopper 아키텍처의 Warp Group Matrix Multiply Accumulate (WGMMA)를 최대한 활용하기 위해 우리는 Swap-AB 변환 방법을 적용했습니다. 이 방법은 행렬 곱셈을 전치하여 하드웨어의 고정된 레이아웃에 맞춰 효율성을 극대화합니다. 이러한 최적화는 대규모 MoE 모델에서 최대 4%의 성능 개선을 기록했습니다.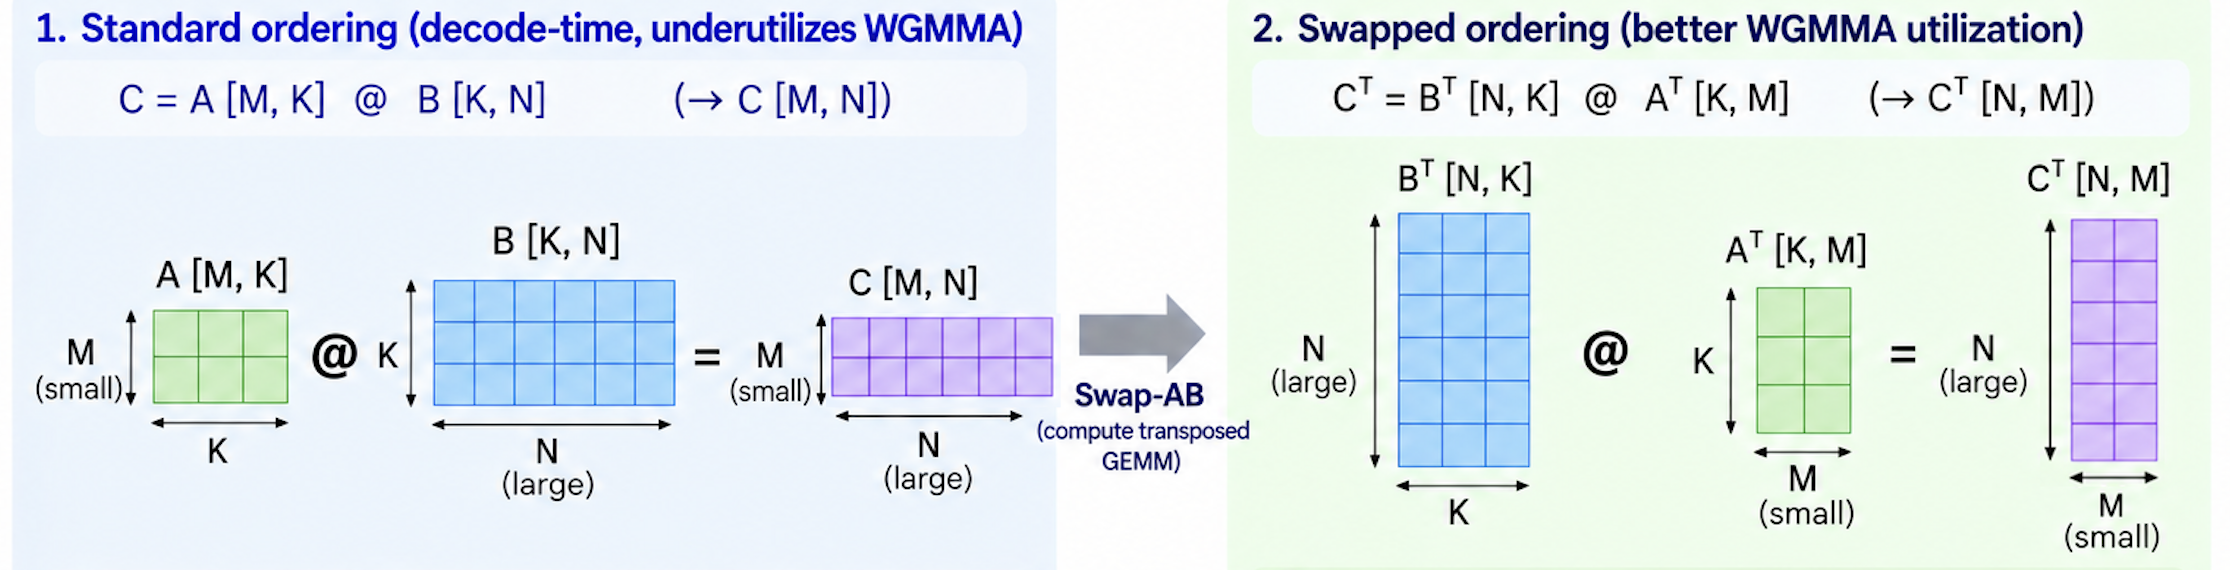
Triton Backend의 장점
FP8 텐서 양자화 모델에서는 Triton Backend가 기존의 FLASHINFER_CUTLASS 경로보다 우수한 성능을 발휘합니다. Triton은 모든 처리 과정을 하나의 하드웨어 패스로 통합하여 성능 병목 현상을 제거합니다. 이러한 방식은 최대 10%의 성능 향상을 가능케 하며, AWS Large Model Inference 컨테이너에 구현되어 있습니다.
Triton JIT 재컴파일 제거
모델 서빙 시 불필요한 커널 재컴파일은 성능에 큰 영향을 미칠 수 있습니다. Triton 컴파일러의 특정 파라미터를 재조정하여 재컴파일을 완전히 제거함으로써 초당 최초 토큰 시간을 9% 개선했습니다. 이러한 최적화는 AWS의 다양한 GPU 클러스터에서 적용되며, 코드 변경 없이도 간단히 업스트림에서 활용할 수 있습니다.
결론
Amazon SageMaker AI와 협력하여 개발된 이러한 최적화는 대규모 MoE 모델에서 최대 10%의 높은 처리 비율 및 최대 9%의 빠른 최초 토큰 생성 시간을 제공합니다. AWS의 다양한 리소스를 활용함으로써, 사용자는 더욱 효율적인 AI 모델을 구축하고 배포할 수 있습니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기