AWS의 효율적인 모델 배포: Concurrency Sweep 활용 가이드
소개
AWS를 통해 AI 모델을 효율적으로 배포하고 싶다면 성능과 비용을 모두 고려한 전략이 필요합니다. 특히 Generative AI 엔드포인트의 효율성을 극대화하기 위해서 Concurrency Sweep이라는 기법을 활용할 수 있습니다. 이 글은 이를 어떻게 활용할 수 있는지, 실제 사례를 통해 성능 최적화를 위한 과정을 설명합니다.
본문
Concurrency Sweep의 핵심 내용
Concurrency Sweep는 Amazon SageMaker AI 엔드포인트에 대한 동시 요청의 증가를 통해 성능을 측정하는 방법입니다. 이는 최적의 인스턴스 구성과 서비스 설정을 찾아, 비용 대비 성능을 극대화하게 해줍니다. 불필요한 리소스를 줄이고, 적절한 서비스 품질을 유지하면서 비용 절감을 실현할 수 있죠.
실제 사례: NVIDIA Nemotron-3 모델 배포
-
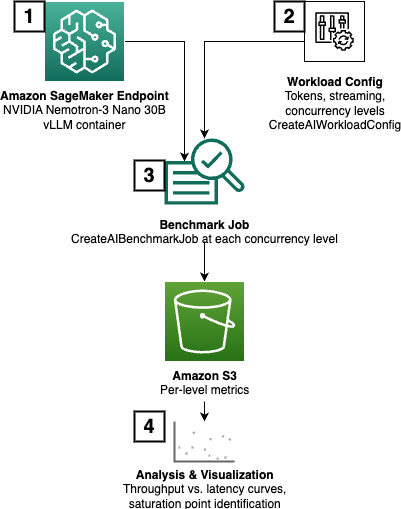
모델 배포: NVIDIA Nemotron-3 Nano 30B 모델을 Amazon SageMaker AI 엔드포인트에 배포합니다. 이 과정에서 vLLM 컨테이너와 GPU 메모리, 미리 정의된 환경 변수를 활용합니다.
-
워크로드 프로파일 구성: CreateAIWorkloadConfig API를 사용하여 현실적인 AI 추론 패턴을 반영하는 트래픽을 정의합니다. 이 때 입력 토큰 길이와 출력 토큰 길이를 설정하여 최대의 성능 효율을 끌어냅니다.
-
Concurrency Sweep 실행: CreateAIBenchmarkJob API를 통해 자동화된 벤치마크 작업을 설정합니다. 이 과정에서 동시성 수준에 따른 성능을 평가하고, 각 수준의 역량을 측정합니다.
-
결과 분석: 수집된 데이터를 통해 처리량과 지연 시간 간의 관계를 확인하며 최적의 작업 조건을 파악합니다. 이를 통해 최적의 인프라 구성을 자동으로 찾아낼 수도 있습니다.
결론
Concurrency Sweep는 기계 학습 서비스를 최적화하기 위한 강력한 도구입니다. 이를 통해 여러 모델 버전과 인스턴스 유형에 대한 자동화된 성능 평가가 가능하며, 데이터 기반으로 인프라 결정을 내릴 수 있습니다. AWS의 Generative AI Inference Recommendations 문서를 참조하면, 보다 구체적인 지침과 모범 사례를 활용할 수 있습니다.
AI, Cloud 관련한 문의는 아래 연락처로 연락주세요!
(주)에이클라우드
이메일 : acloud@a-cloud.co.kr
회사 번호 : 02-538-3988
회사 홈페이지 : https://www.a-cloud.co.kr/
문의하기